DAIV CX-A9A60 は、マウスコンピューターのクリエイター向けブランド DAIV から発売された小型デスクトップです。
CPU は Ryzen AI Max+ 395、メモリは 128GB。このうち最大96GB を VRAM(グラフィックス用のメモリ)に割り当てられます。
RTX 4090 や RTX 5090 などの GPU には載らない大きな AI モデルも、手元で動かせるのが特徴。
本記事では、DAIV CX-A9A60 を使った感想と、ローカル AI を動かして確かめた良いところ・気になる点をレビューしていきますので、ぜひご参照ください。
※本レビューはマウスコンピューター様より製品をお貸しいただきレビューしています
DAIV CX-A9A60 の基本的な仕様
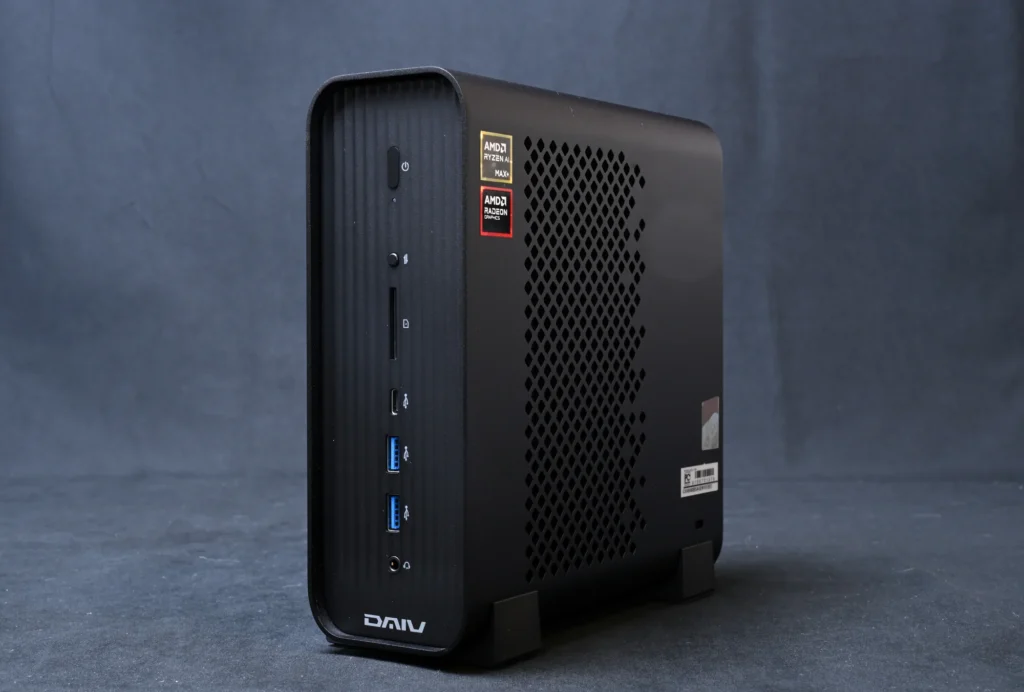
スペックと特徴
| 項目 | スペック |
|---|---|
| 価格 | 949,800円(税込) |
| CPU | AMD Ryzen AI Max+ 395(16コア32スレッド) |
| グラフィックス | AMD Radeon 8060S(CPU内蔵)/メモリから VRAM を最大96GB 割り当て |
| メモリ | 128GB LPDDR5X-8000(オンボード・増設不可) |
| SSD | 2TB NVMe Gen4(M.2 スロットの空き1) |
| サイズ・重量・電源 | 幅70×奥行198×高さ200mm/約1.98kg/250W ACアダプタ |
| 保証 | 3年間センドバック修理保証/24時間365日電話サポート |
主な特徴は、以下の通りです。
- 128GB のメモリのうち、最大96GB をグラフィックス用(VRAM)に割り当てられる
- 出荷時点で 96GB を割り当て済み
- 前面のボタンで、パフォーマンスモードと静音モードを切り替えられる
- USB4(40Gbps)を前面と背面に1つずつ、2.5GBASE-T の有線LANと Wi-Fi 7 を搭載
- 3年間のセンドバック修理保証と、24時間365日の電話サポート
※検証は Windows 11 Pro・LM Studio 0.4.26・出荷時の設定(VRAM 96GB、パフォーマンスモード)で行いました。比較には、Core i9-10850K・メモリ64GB・RTX 3090(VRAM 24GB)の PC と、Core Ultra 7 265K・メモリ64GB・RTX 5070 Ti(VRAM 16GB)の PC を使っています。
同梱品
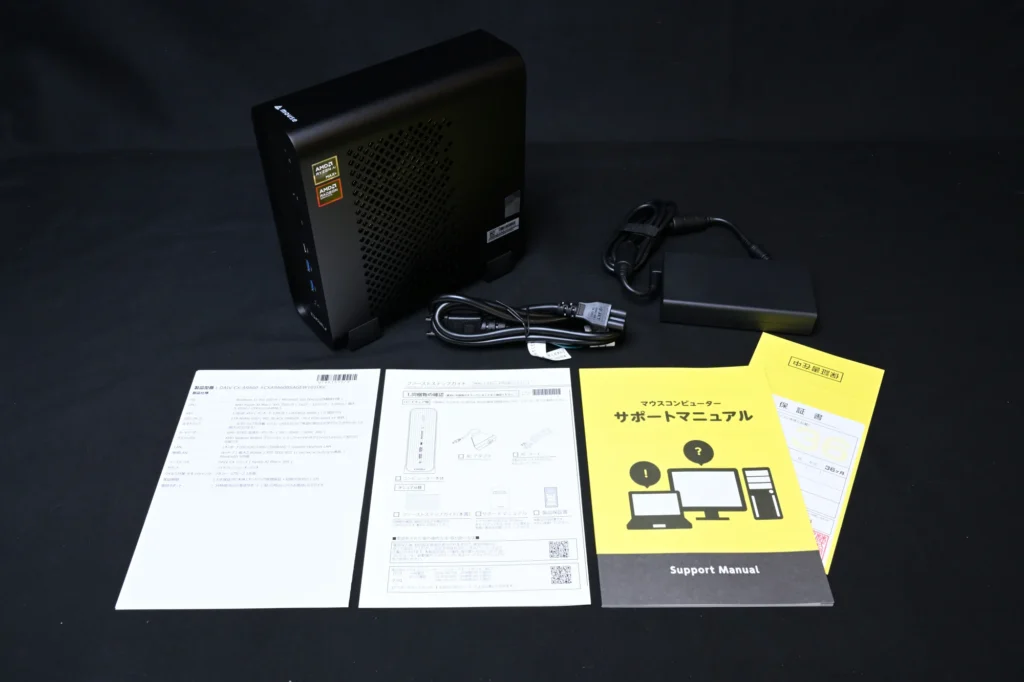
同梱品は、以下の6点です。
- コンピューター本体
- ACアダプタ
- ACコード(電源コード)
- ファーストステップガイド
- サポートマニュアル
- 製品保証書
このほかに、型番と仕様をまとめた製品仕様書が1枚入っています。モニター・キーボード・マウスは付属しないので、別に用意が必要です。
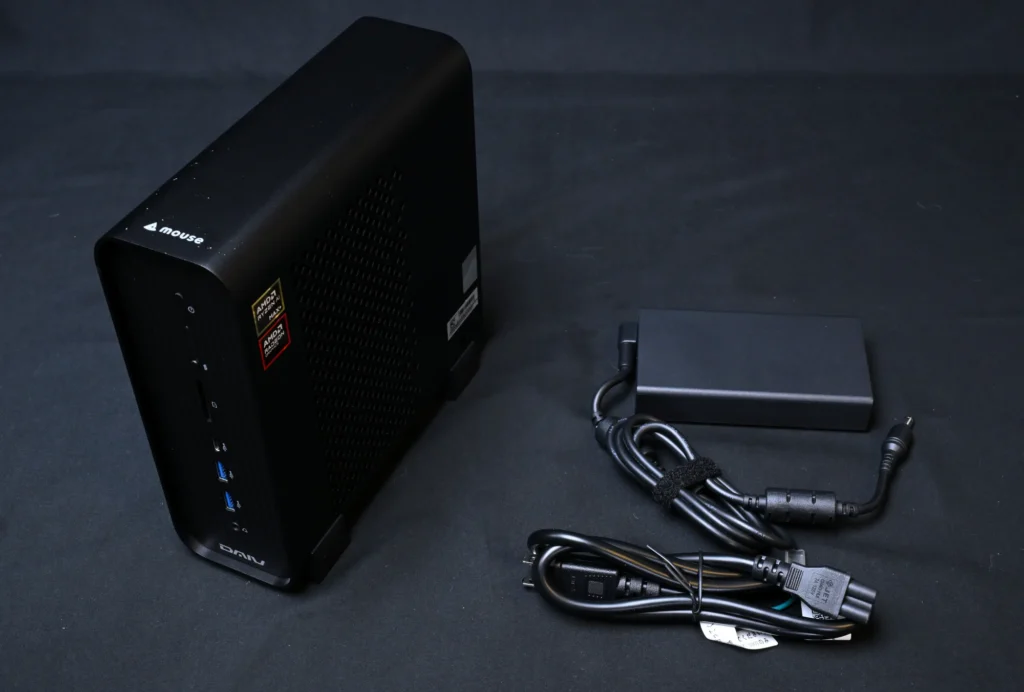
電源は、250W の ACアダプタを本体背面の DC IN につなぐ方式。端子や設定の詳しい説明は紙では入っておらず、Windows のデスクトップにあるハードウェアマニュアル(PDF)で確認する形です。
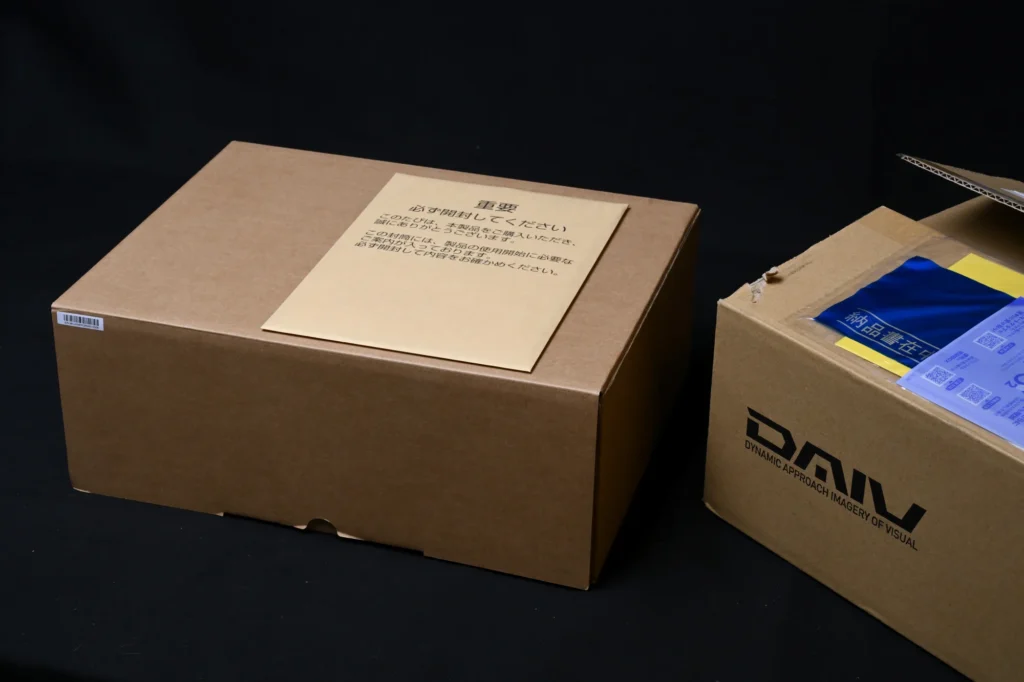
梱包は、DAIV のロゴが入った外箱の中に内箱があり、本体は発泡材で固定されています。箱はシンプルで軽く、配達のときは片手で持ち上げて走って運ばれてきたので、少しヒヤッとしました。
届いたら、まず電源を入れて動作を確かめておくと安心です。初期不良として対応してもらえるのは製品到着日から1ヶ月、欠品は2週間まで。
デザイン
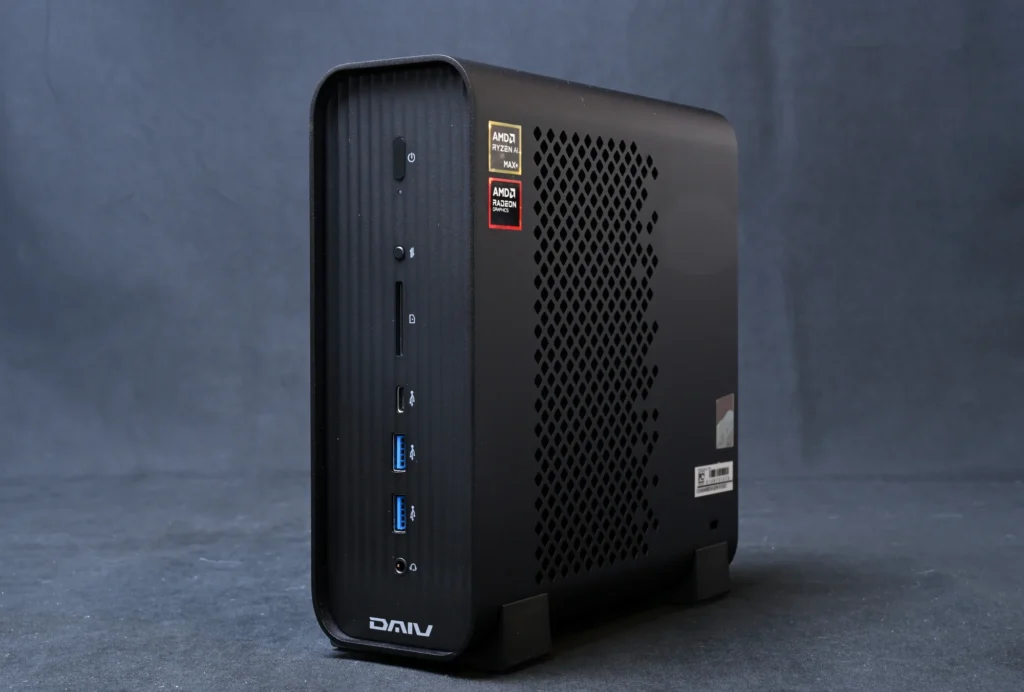
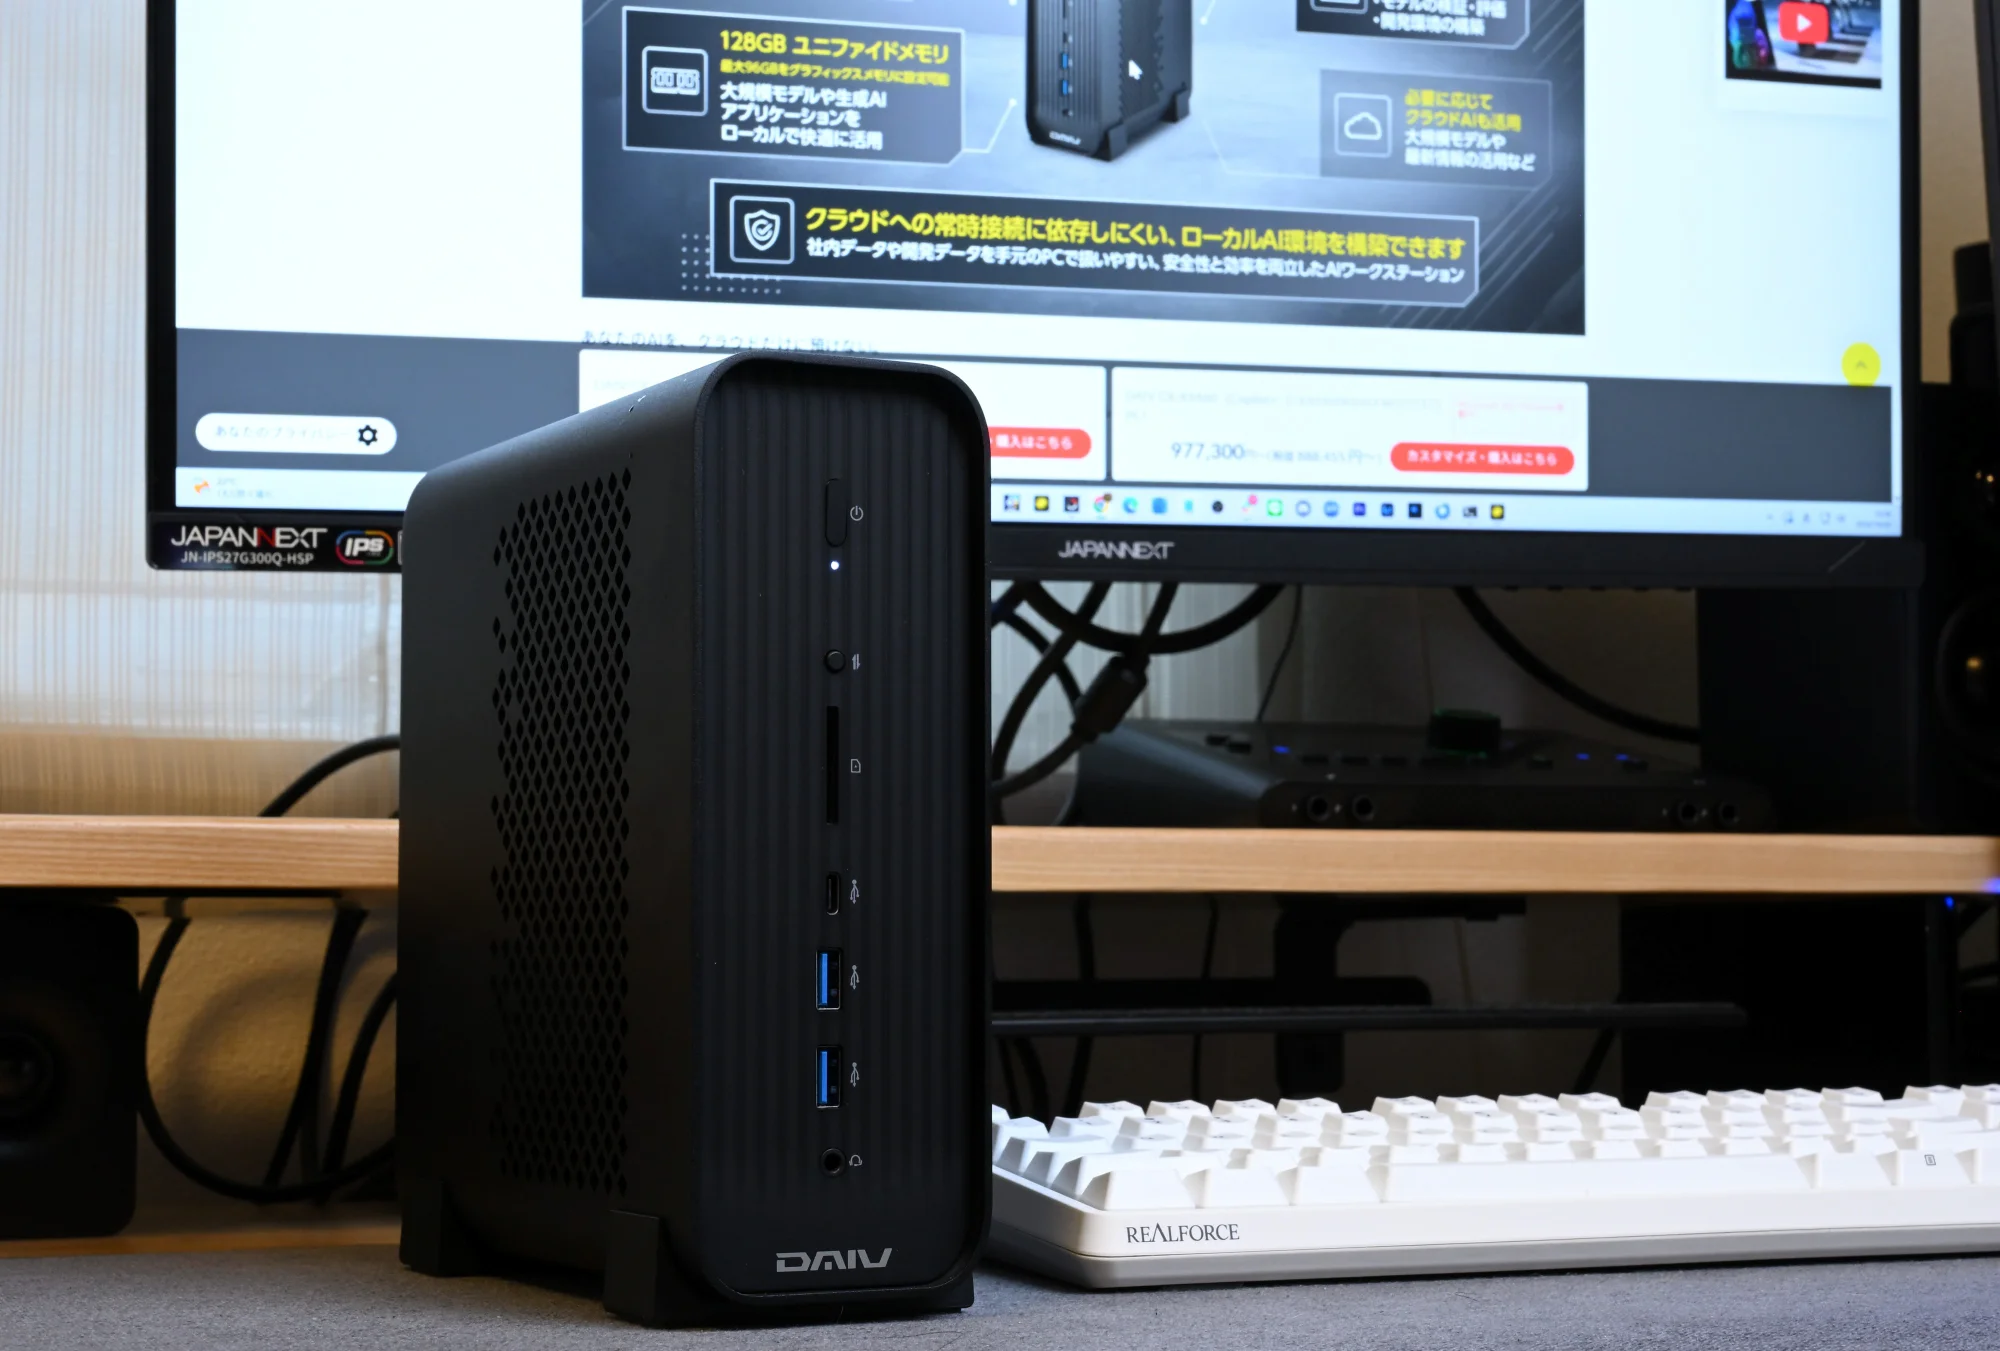
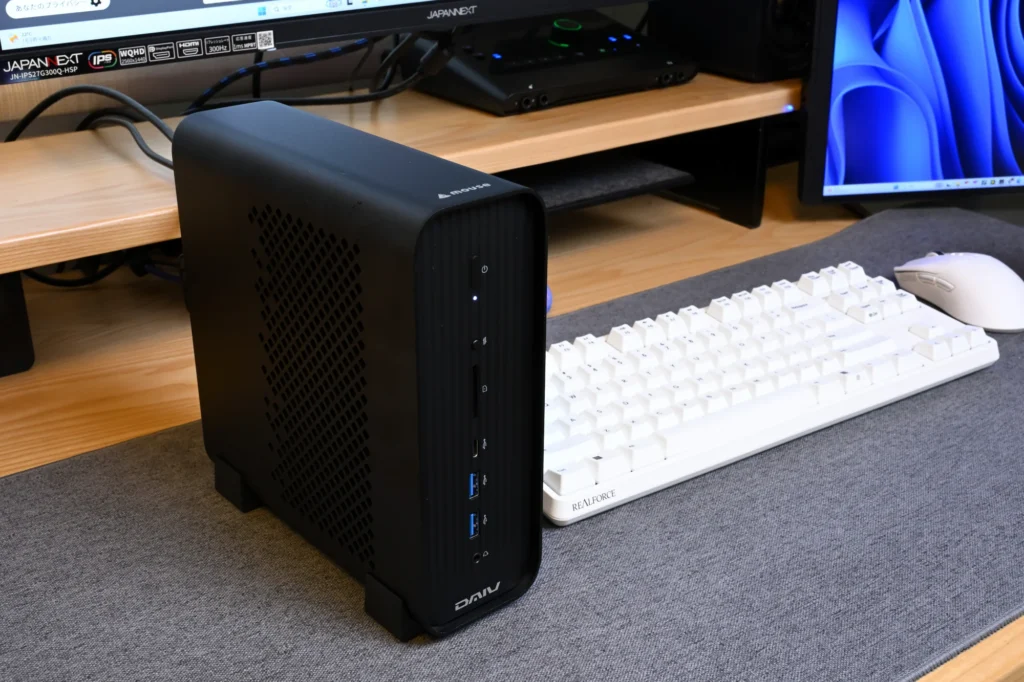
本体は縦置きの筐体です。脚などの突起を含めると、置くのに必要な幅は 78.5mm。
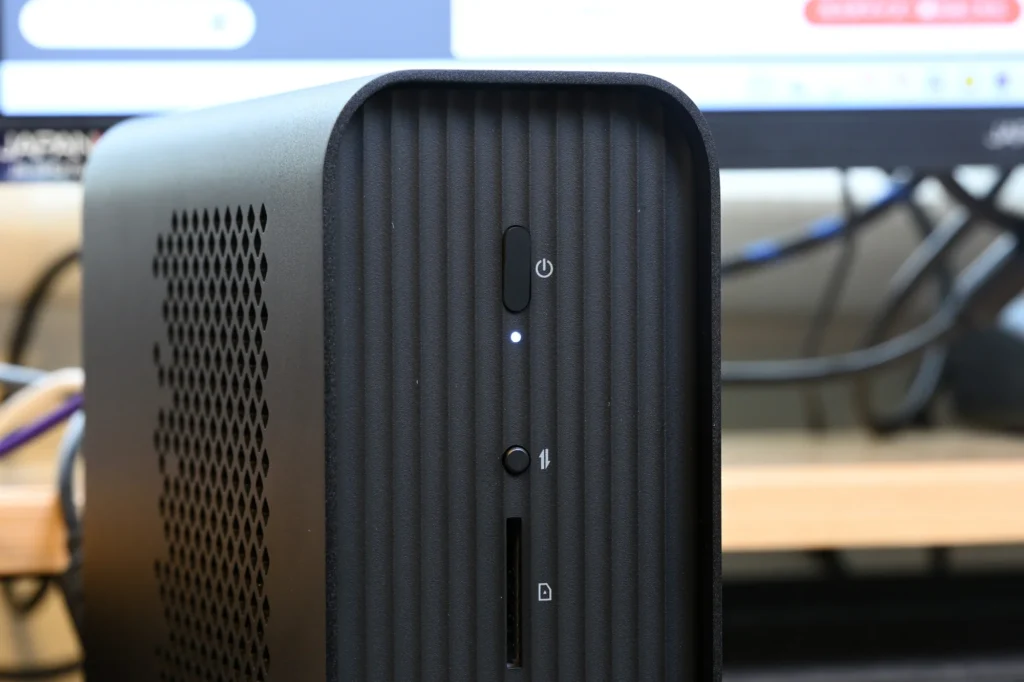
前面は縦に溝が入ったパネルで、上から電源ボタン、動作ランプ、動作モード切替スイッチ、SD スロットの順。電源ボタンは指紋認証のセンサーを兼ねていて、Windows のサインインを指紋で済ませられます。
SD スロットの規格は UHS-II です。UHS-II は、カードの端子を2列にして転送を速くした SD カードの規格で、最大 312MB/s(UHS-I は最大 104MB/s)。対応カードなら、カメラで撮った写真や動画を短い時間で取り込めるのが利点です。
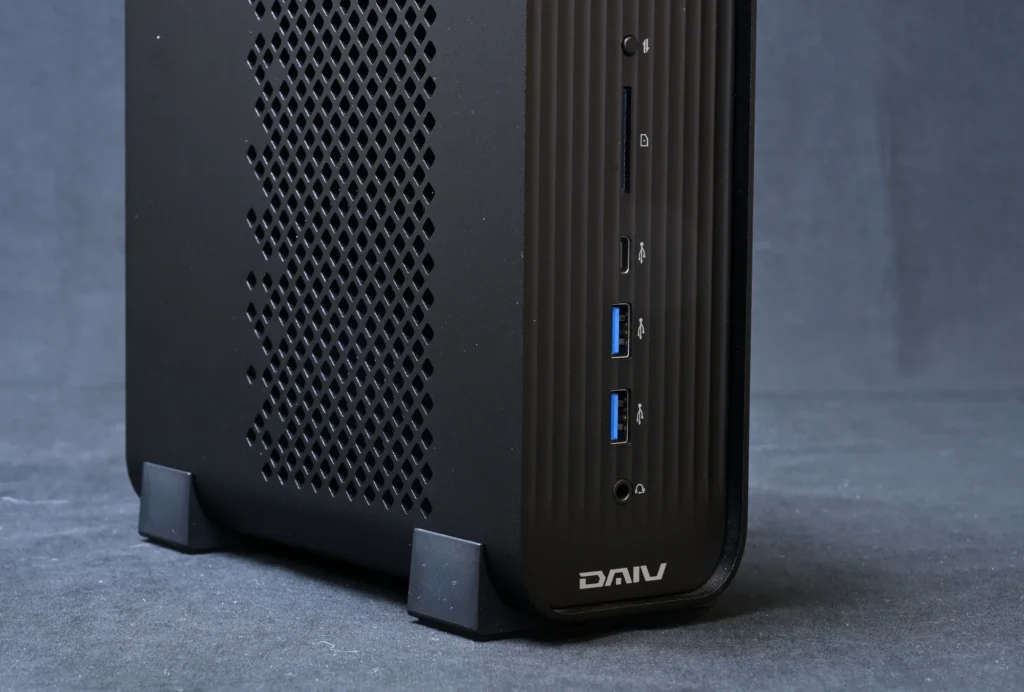
その下には、USB4(Type-C)、USB 3.2 Gen2(Type-A)×2、ヘッドセット端子が並びます。前面の USB4 は、40Gbps のデータ転送と DisplayPort Alt Mode の映像出力に対応した端子です。
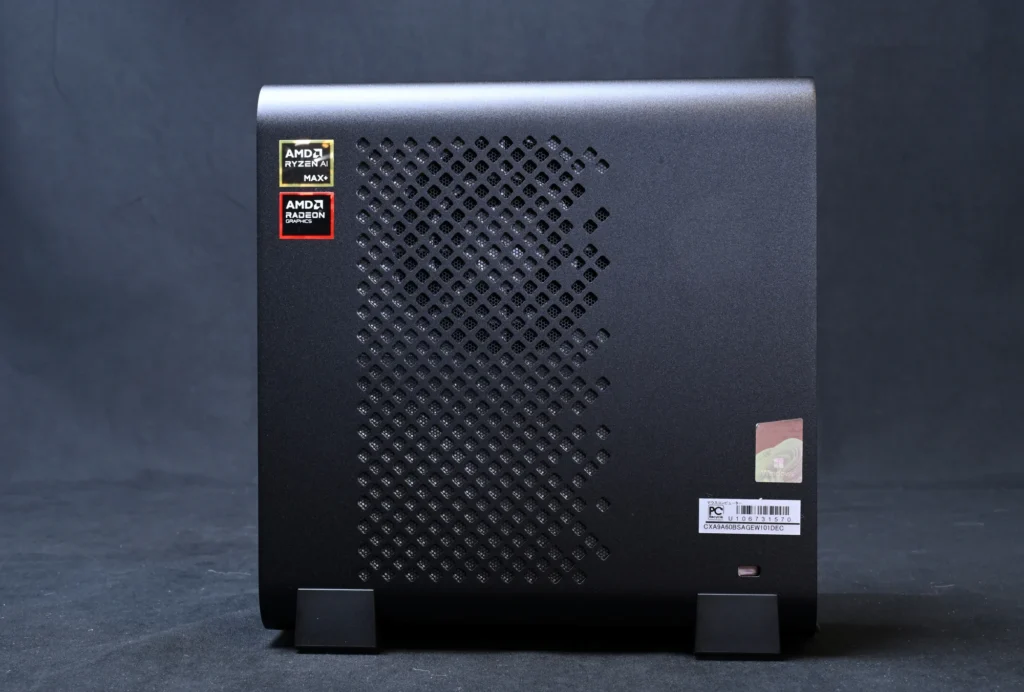
右側面には、AMD のステッカーとメッシュの通気口、盗難防止用のセキュリティスロットがあります。
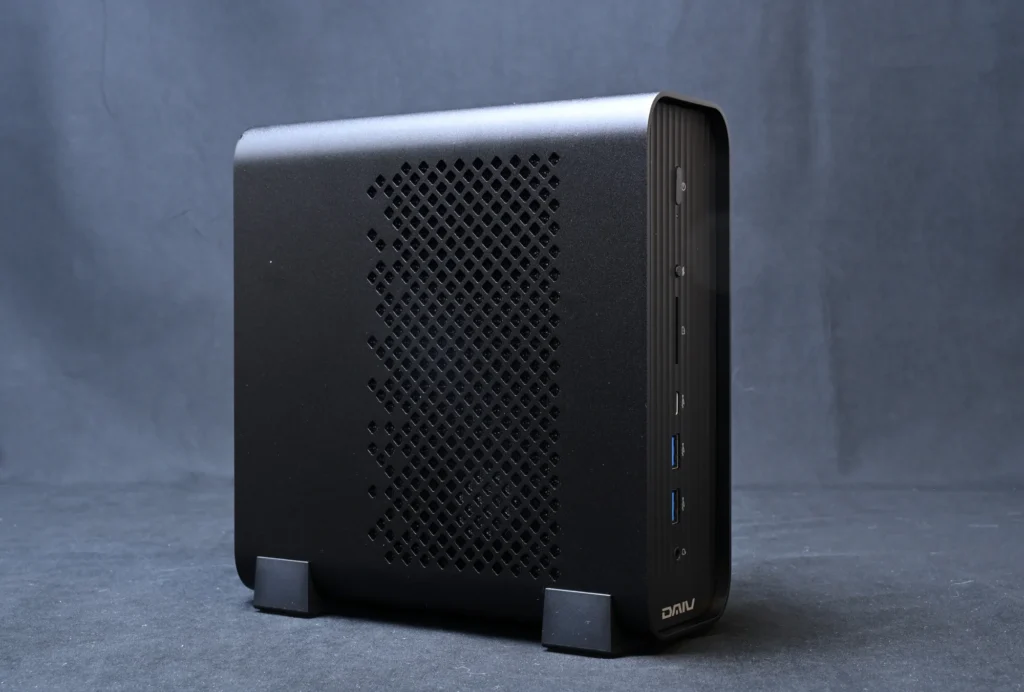
左側面は、メッシュの通気口だけ。
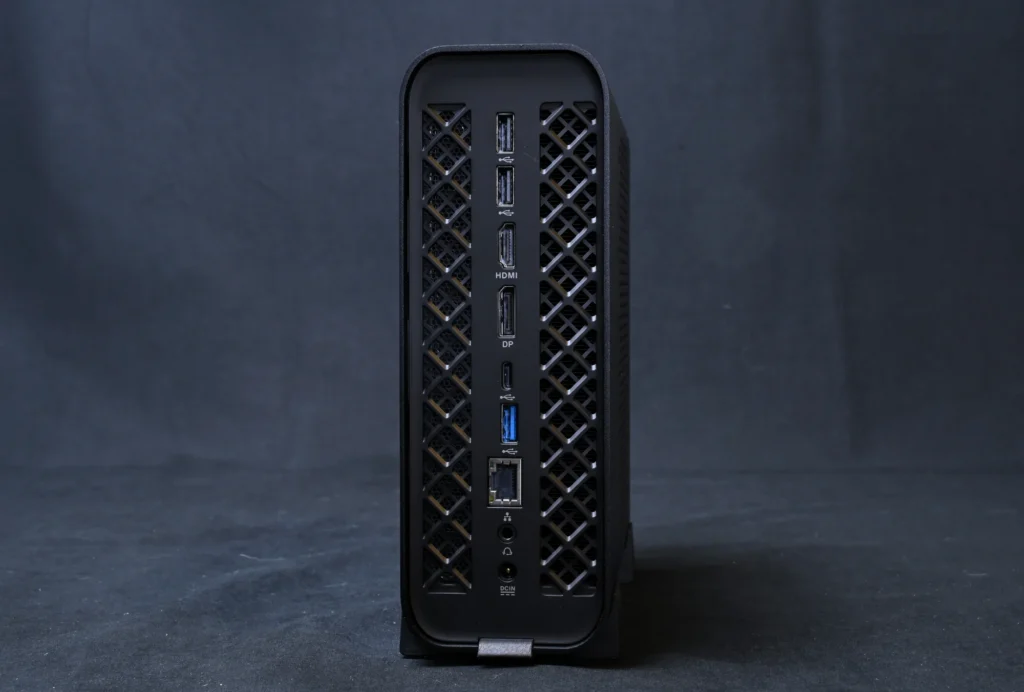
背面の端子は、上から以下の通りです。
- USB 2.0(Type-A)×2
- HDMI
- DisplayPort
- USB4(Type-C)
- USB 3.2 Gen2(Type-A)
- 有線LAN(2.5GBASE-T)
- ヘッドセット端子
- 電源(DC IN)
映像出力は、HDMI・DisplayPort・前後の USB4 を合わせて、最大4画面まで使えます。DisplayPort の出力は、最大で 3840×2160・144Hz です。
各種設定
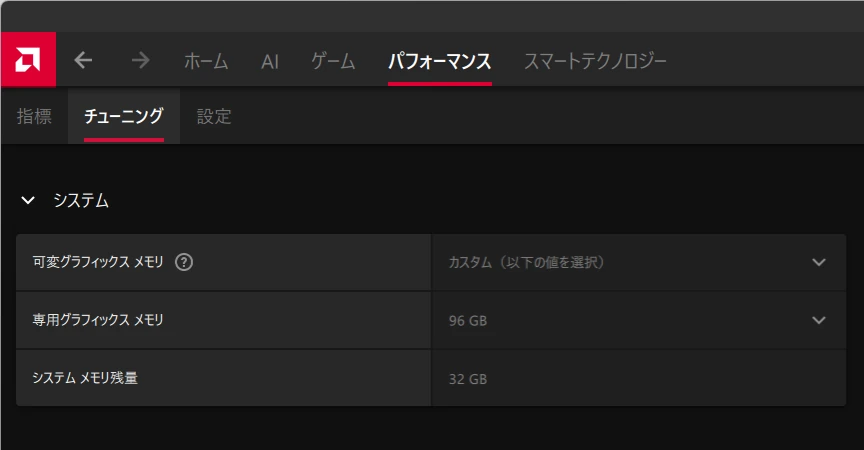
VRAM にどれだけ割り当てるかは、Adrenalin の「可変グラフィックスメモリ」で変えられます。選択肢は 1GB から 96GB までの8段階で、出荷時は 96GB に設定されていました。
残りの 32GB は、Windows やアプリが使うメモリです。同じ割り当ては、BIOS の「UMA Frame buffer Size」からも選べます。
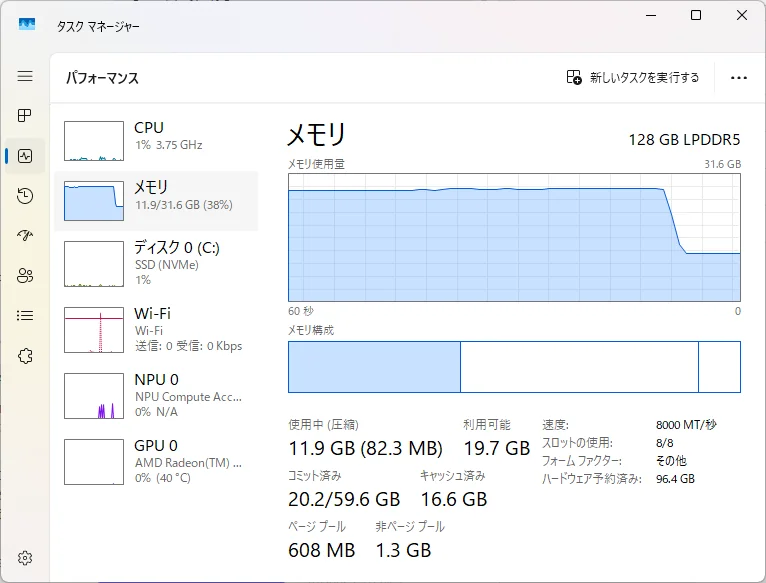
96GB 設定のままだと、Windows で使えるメモリは 31.6GB。gpt-oss-120b のように 60GB を超えるモデルを使わないなら、VRAM を 64GB に下げると、Windows 側にも 64GB を残せます。
VRAM を 64GB にして gpt-oss-120b を読み込むと、速度は 50.1 tok/s から 36.5 tok/s に落ち、Windows 側のメモリもほぼ埋まりました。
前面の上下矢印のボタンは、動作モード切替スイッチです。押すたびに画面中央に「Silent Mode」「Performance Mode」と表示され、静音モードとパフォーマンスモードが切り替わります。
出荷時の設定はパフォーマンスモード。gpt-oss-120b に2,000字の文章を書かせると、パフォーマンスモードは 47.0 tok/s、静音モードは 43.5 tok/s でした。
生成中の GPU 温度は、パフォーマンスモードで 70℃、静音モードで 52℃ です。静音モードにすると、生成速度は7%ほど落ちますが、GPU 温度は 18℃ 下がりました。
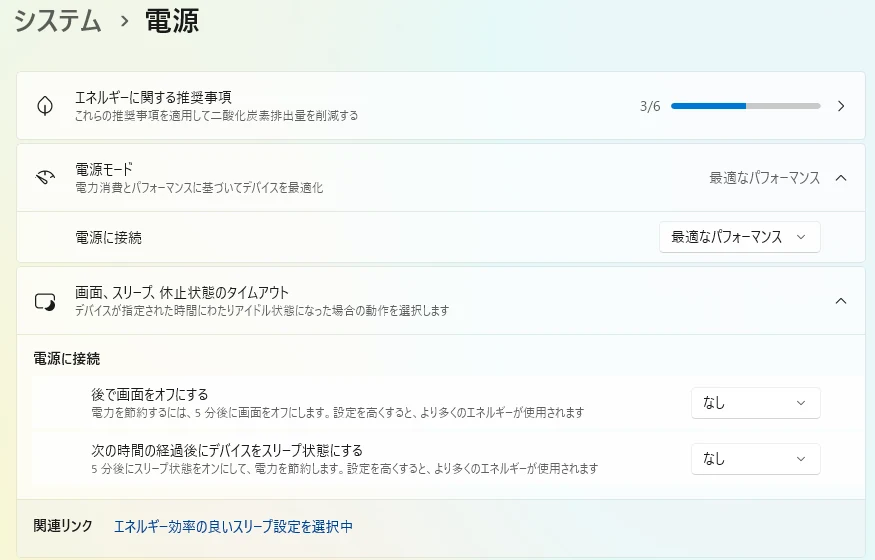
出荷時の Windows は、スリープが有効です。63GB の gpt-oss-120b をダウンロードしている途中でスリープに入り、ダウンロードが止まりました。
大きなモデルをダウンロードする前に、Windows の設定でスリープを「なし」に変えておけば、途中で止まりません。
マウスコンピューターについて
マウスコンピューターは、東京都千代田区に本社を置くパソコンメーカーです。1993年に、受注生産のパソコンで事業を始めました。工場は、長野県飯山市にあります。
主なブランドは、幅広い用途向けの mouse、ゲーミング向けの G TUNE と NEXTGEAR、クリエイター向けの DAIV です。
電話サポートは24時間365日受け付けていて、ほかに LINE・メール・AIチャットでも問い合わせできます。修理の目標は、平均72時間以内の完了です。本機には、3年間のセンドバック修理保証が付きます。
RTX 3090 搭載PCとの比較
単体 GPU の PC とどれくらい違うのかを確かめるため、RTX 3090(VRAM 24GB)を載せた PC でも、同じ条件で速度を測りました。条件は、LM Studio 0.4.26・コンテキスト長 16384・推論 Low で揃えています。
| モデル | 容量 | DAIV CX-A9A60 | RTX 3090 搭載PC |
|---|---|---|---|
| gpt-oss-20b | 12.1GB | 69.2 tok/s | 約153 tok/s |
| Qwen3.8-27B(Q4) | 17.7GB | 17.9 tok/s | 24.4 tok/s |
| gpt-oss-120b | 63GB | 50.1 tok/s | VRAM に収まらない(未計測) |
| Llama 3.3 70B(Q4) | 42.5GB | 5.3 tok/s | VRAM に収まらない(未計測) |
VRAM に収まるモデルは、RTX 3090 のほうが速い結果でした。gpt-oss-20b で約2.2倍、Qwen3.8-27B で約1.4倍の差です。
差が出た理由は、メモリの読み出し速度(帯域)の違いだと考えられます。RTX 3090 の VRAM は 936GB/s、本機のメモリは計算上 256GB/s。容量は本機が4倍ある一方、読み出しの速さは RTX 3090 が3倍以上です。
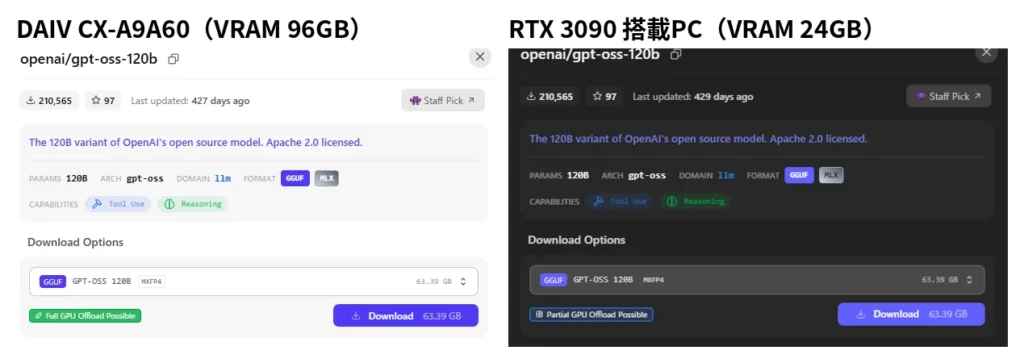
63GB の gpt-oss-120b は、RTX 3090 の PC だと LM Studio の判定が「Partial GPU Offload Possible」で、GPU に載せきれません。DAIV CX-A9A60 では「Full GPU Offload Possible」と表示され、モデル全体を VRAM に読み込めました。
長い資料を一度に読ませたときも、同じ傾向が出ています。マニュアルの写真26枚(約6.2万トークン)は RTX 3090 の PC のほうが速く答えた一方、製品写真を足した約10.4万トークンは VRAM 24GB に収まりませんでした。
VRAM 16GB の RTX 5070 Ti を載せた PC では、モデル自体が VRAM に収まらず、同じ26枚に約76分かかりました。本機は約8分半です。
VRAM に収まる大きさのモデルや、長さの資料なら、単体 GPU の PC のほうが速く動きます。60GB を超えるモデルや、10万トークンを超える長い資料を、VRAM に収めたまま扱えるのが本機の強みです。
DAIV CX-A9A60 の良いところをレビュー
LM Studio でいくつかのモデルを動かし、紙のマニュアルと製品写真も読ませた結果から、良いところをまとめました。
LM Studio を入れるだけで、120B のモデルが動く
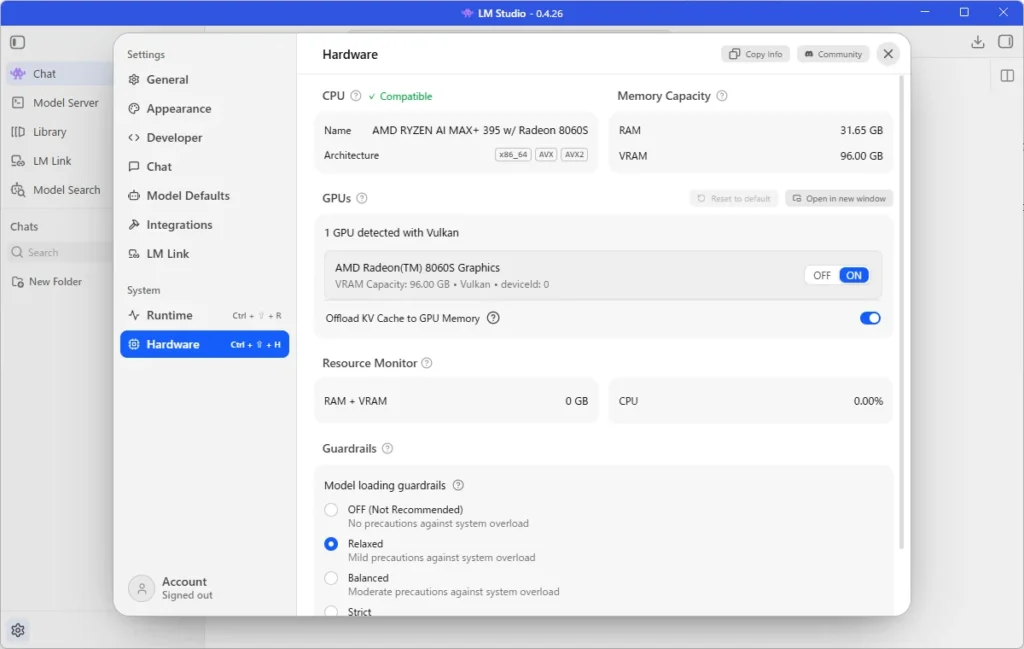
Windows に LM Studio 0.4.26 をインストールして開くと、ハードウェアの画面に「1 GPU detected with Vulkan」「AMD Radeon 8060S」「VRAM 96.00GB」と表示されました。ドライバーの追加や設定の変更は、何もしていません。
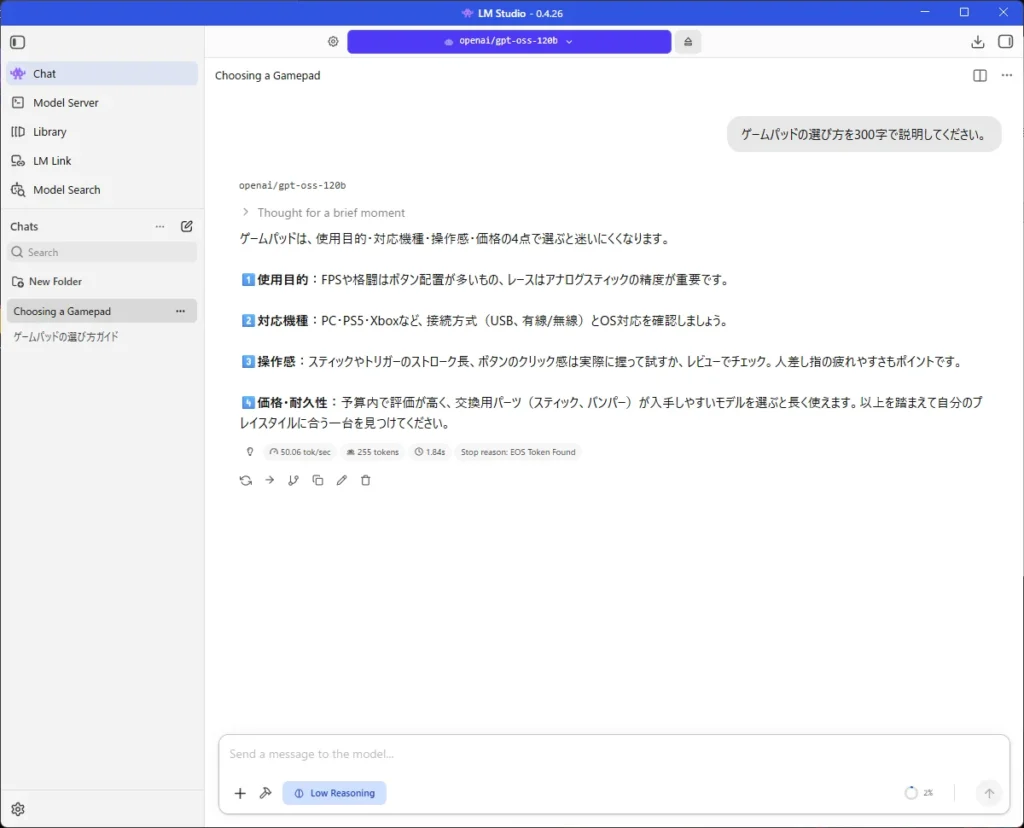
gpt-oss-120b(63GB)の読み込みは、約95秒。300字の文章を書かせると、毎秒50.1トークンで出力しました。
Ryzen AI Max+ 395 でローカル LLM を動かす解説記事を検索すると、Linux や ROCm の環境を整える手順を扱うものが上位に並びます。本機では Windows のまま、LM Studio をインストールしただけで 120B のモデルまで動きました。
出荷時点で VRAM が 96GB に設定されているので、BIOS や Adrenalin を開かずに、そのまま大きなモデルを読み込めます。
マニュアルと製品写真、約50枚を一度に読ませて照合までできる
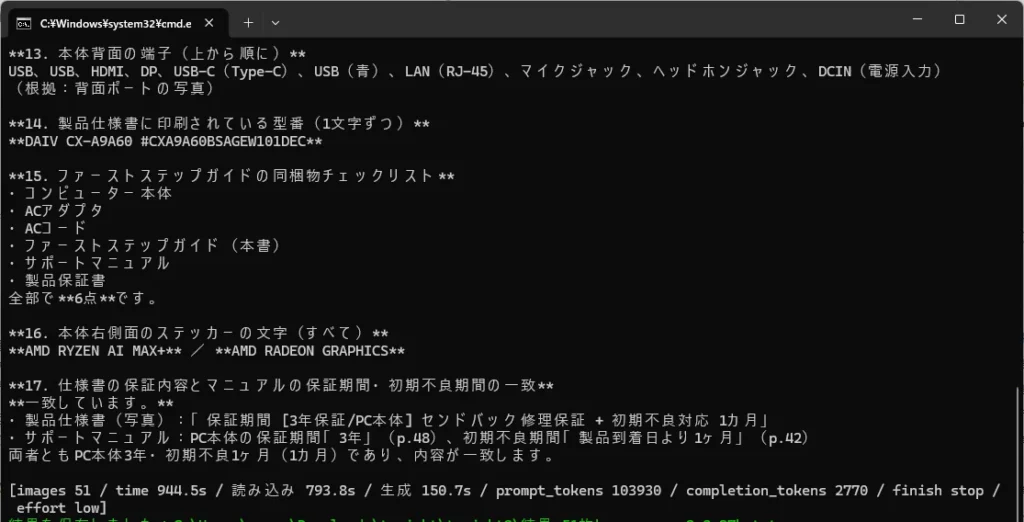
本機に付属するサポートマニュアル(52ページ)を見開きで撮った写真26枚と、本体や付属品を撮った写真25枚。合わせて51枚を、画像を読める Qwen3.8-27B に一度に渡しました。
入力は、約10.4万トークン。読み込みに約13分、回答まで含めて944.5秒かかり、17問中16問に正しく答えています。
完全放電の手順や修理の窓口は、根拠のページ番号を付けて答えました。製品仕様書に印刷された型番「CXA9A60BSAGEW101DEC」も、1文字も違えずに読み取っています。
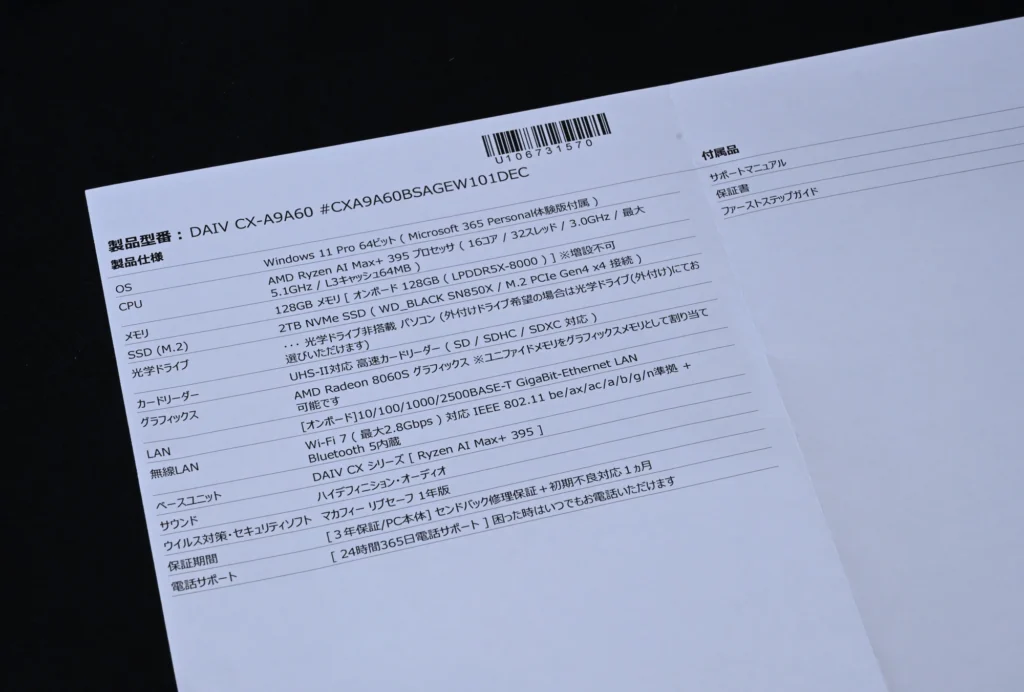
写真の製品仕様書にある「3年保証/PC本体 センドバック修理保証+初期不良対応 1カ月」を、マニュアルの保証期間と初期不良期間に突き合わせ、「一致している」とも答えました。
約10.4万トークンは、RTX 3090 の PC では VRAM に収まらない量です。社外に出せないマニュアルや仕様書も、外部のサービスに送らずに、写真のまままとめて AI に読ませられます。
大きな MoE モデルなら、小さなモデルと変わらない速さで動く
gpt-oss-120b は、総パラメータが約1,170億あるモデルです。中身は128個のエキスパートに分かれていて、1トークンを出すたびに使うのはそのうち4個だけ。この仕組みが MoE(Mixture of Experts)です。
同じ条件で5つのモデルを動かした速度を、以下にまとめました。
| モデル | 種類 | 容量 | 生成速度 |
|---|---|---|---|
| gemma-4-e4b | 小型(実効4B) | 6.3GB | 52.6 tok/s |
| gpt-oss-20b | MoE | 12.1GB | 69.2 tok/s |
| gpt-oss-120b | MoE | 63GB | 50.1 tok/s |
| Qwen3.8-27B(Q4) | 密モデル | 17.7GB | 17.9 tok/s |
| Llama 3.3 70B(Q4) | 密モデル | 42.5GB | 5.3 tok/s |
※量子化の形式は、gpt-oss の2モデルが MXFP4、ほかの3モデルが Q4_K_M。
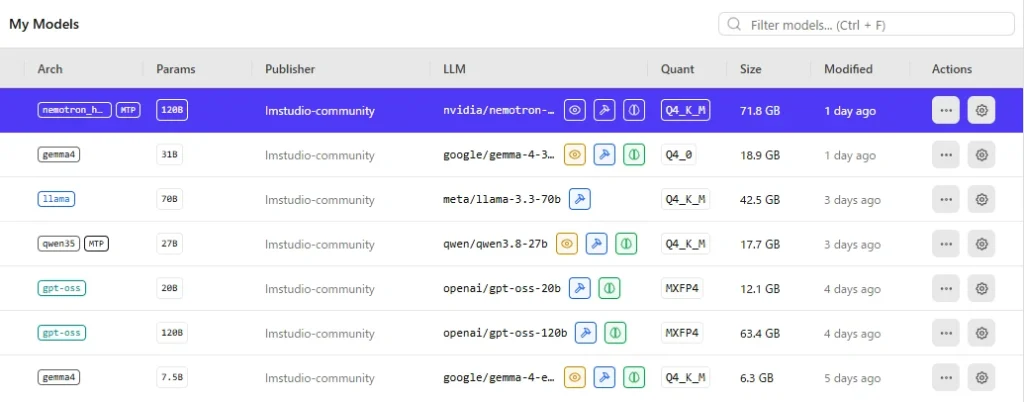
63GB の gpt-oss-120b は、6.3GB の gemma-4-e4b とほぼ同じ速さです。1トークンごとに全部のパラメータを使う密モデルは容量が大きいほど遅く、Llama 3.3 70B は 5.3 tok/s でした。
本機で大きなモデルを使うなら、MoE のモデルを選べば、速度を落とさずに済みます。
ただし、読ませる文章が長くなると、生成速度は半分ほどまで落ちました。gpt-oss-120b の生成速度は、約1,500トークンの入力なら 52.7 tok/s、約9.5万トークンでは 27.3 tok/s。読み込みの速さは、約1.7万トークンで毎秒726トークン、約9.5万トークンで毎秒346トークンです。
照合とツール呼び出しなら、ローカルの 120B に任せられる
LM Studio で動かした5つのモデルに、照合・ツール呼び出し・知識を問う課題と、文章を書く課題2つの、計5つの課題を出しました。比べる相手は、クラウドの Claude Opus 5.5 です。
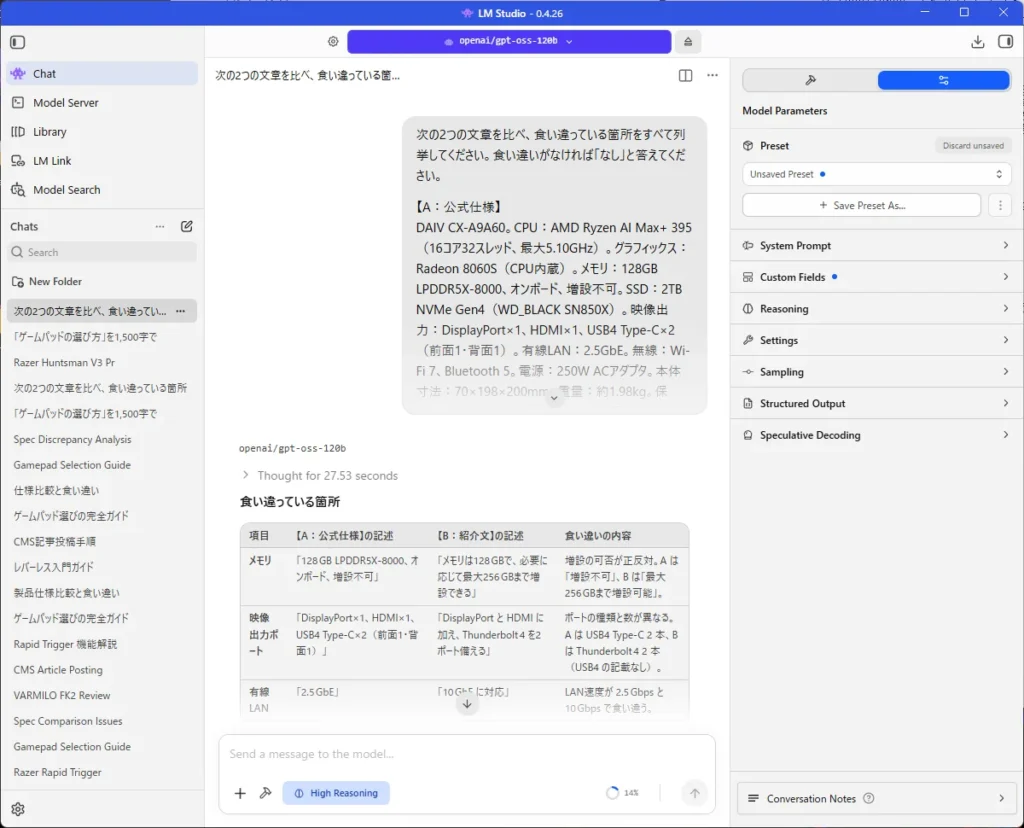
照合の課題では、仕様表と記事の食い違い5か所を、5モデルとも見つけています。推論を High にすると、食い違いではない箇所への誤った指摘は、gpt-oss-120b では1件まで減りました。gpt-oss-20b は逆に7件に増えています。
ツール呼び出しでは、下書きの作成から翌日9時の予約投稿までの手順を、gpt-oss-120b は JSON で正しく出せました。照合もツール呼び出しも本機の中で動くので、資料を外部のサービスに送らずに済みます。何度使っても、利用量に応じた料金はかかりません。
一方で、知識を問う課題と文章を書く課題は、どのモデルもそのまま使える結果になりませんでした。ラピッドトリガーについて尋ねた知識の課題では、gpt-oss-120b の回答は中身がすべて創作です。この3つの課題で、そのまま使える回答を返したのは Claude Opus 5.5 だけでした。
これは本機ではなく、いまローカルで動かせるオープンモデルの限界です。
新しいモデルが出れば、結果も変わる可能性があります。試すときは、LM Studio で新しいモデルをダウンロードして読み込むだけです。
幅70mm の小さな本体で 120B のモデルが動く
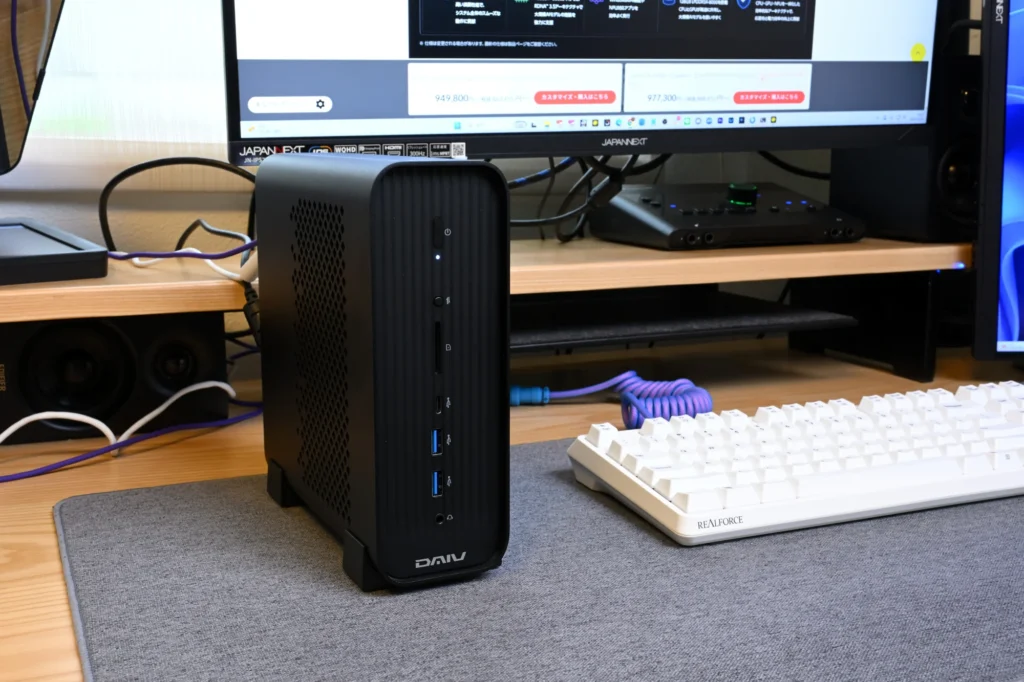
本体のサイズは幅70×奥行198×高さ200mmで、容積は約2.8L。重さは約1.98kgあります。
63GB の gpt-oss-120b を VRAM に収めるには、RTX 5090(32GB)なら2枚、RTX 4090(24GB)なら3枚分の VRAM が必要な計算です。本機は、その大きさのモデルを1台の小さな本体の VRAM に載せて動かせます。
写真のように、モニターの脇に縦置きで置ける大きさ。大きな AI モデルを動かすために、机の下に大きなタワー型の PC を据える必要はありません。
長い生成でもファンの音は小さい
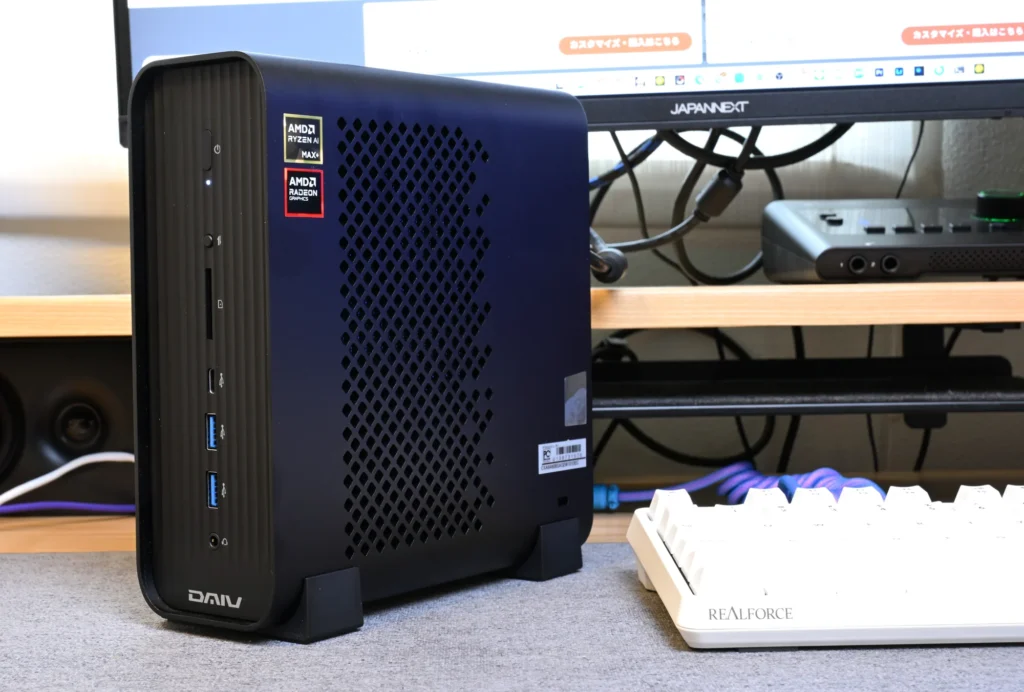
数秒で終わる短い生成では、ファンの音は聞こえませんでした。筐体に触れても、熱は感じない程度です。
推論を有効にして4〜5分かかる生成を何度か続けると、ファンの音が聞こえてきます。ただ、うるさいと感じる大きさにはなりませんでした。筐体は、触るとほんのり温かい程度。
静音モードとパフォーマンスモードでは、ファンの音に少し差を感じました。どちらのモードでもきわめて静かですが、無音ではありません。
マニュアルでは、ACアダプタは動作中に高温になるとして、電源コードを束ねないよう案内しています。
DAIV CX-A9A60 の気になる点をレビュー
購入前に確認しておきたいのは、価格とメモリの配分の2点です。
同じチップの格安ミニPCよりは、価格が高い
DAIV CX-A9A60 の価格は、949,800円(税込)。128GB のメモリを積んだ AI 向けの機種と並べると、以下の通りです。
| 製品 | 形 | チップ | 価格 |
|---|---|---|---|
| GMKtec EVO-X2(128GB・2TB、リンクス直販) | ミニPC | Ryzen AI Max+ 395 | 718,000円(税込) |
| DAIV CX-A9A60(128GB・2TB) | 小型デスクトップ | Ryzen AI Max+ 395 | 949,800円(税込) |
| Apple Mac Studio(M5 Max・128GB・2TB) | 小型デスクトップ | Apple M5 Max | 1,031,800円(税込) |
| ASUS ProArt P16 H7607(128GB・1TB) | 16型ノート | NVIDIA RTX Spark N1X | 1,248,000円(税込) |
| HP Z2 Mini G1a(128GB・2TB) | ミニワークステーション | Ryzen AI Max+ PRO 395 | 2,854,500円(税込) |
同じ Ryzen AI Max+ 395 のミニPCなら、国内正規代理店のリンクスインターナショナルが扱う GMKtec EVO-X2 のほうが安く買えます。ただ、リンクスの直販は受注生産で、届くまで1.5〜2ヵ月かかり、保証は1年です。
本機は決済から約4営業日で出荷され、3年間のセンドバック修理保証と、24時間365日つながる電話窓口が付きます。GMKtec の楽天の直販は、原則として個人輸入の扱いで、中国から直送される形です。
一方で、128GB のメモリを積んだ AI 向けの機種には、本機より高いものも並びます。NVIDIA RTX Spark を載せた ASUS の16型ノート ProArt P16 は 1,248,000円。同じチップの PRO 版を載せた HP のワークステーション Z2 Mini G1a は、128GB の構成で 2,854,500円です。
Apple の Mac Studio は、M5 Max・メモリ128GB・SSD 2TB を選ぶと 1,031,800円。メモリの読み出し速度は 614GB/s と本機の2倍以上あり、生成速度では Mac Studio が有利と考えられます。ただ、OS は macOS なので、Windows のアプリと同じ PC で使いたい方には向きません。
表の5機種で、国内メーカーの3年保証が付くのは本機だけです。
VRAM を 96GB にすると、Windows 側のメモリに余裕がない
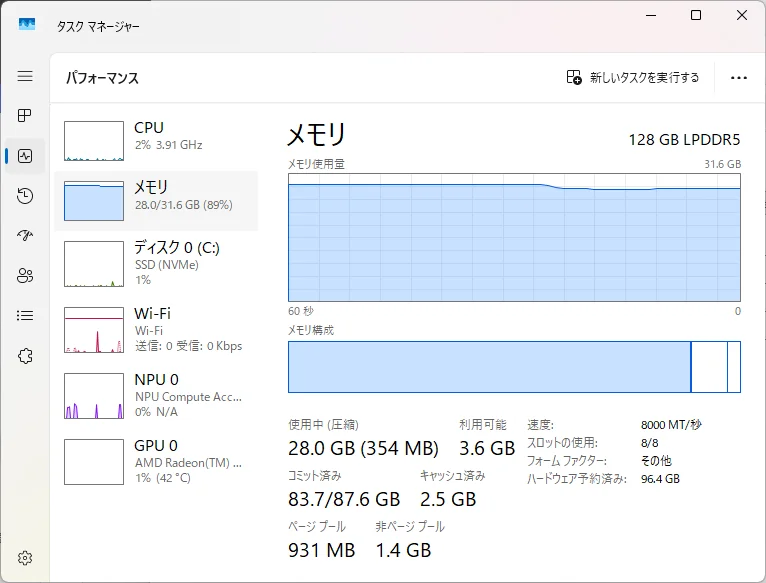
VRAM を 96GB にした状態で gpt-oss-120b を読み込むと、Windows 側のメモリは 31.6GB のうち 28.0〜31.4GB が埋まりました。空きは 0.3〜3.6GB です。
モデルを取り出す(Eject)と、使用量は 11.9GB に戻りました。gpt-oss-120b を読み込むだけで、Windows 側のメモリも16GB 以上使っている計算です。
モデルを読み込んだまま、メモリを多く使うアプリを並べて動かす余裕はありません。メモリはオンボードで増設できないため、あとから足すこともできない仕様です。
60GB を超えるモデルを使わないなら、各種設定で触れたように、VRAM を 64GB に下げて Windows 側に 64GB を残す方法があります。
まとめ
DAIV CX-A9A60 は、Ryzen AI Max+ 395 を搭載し、128GB のメモリのうち 96GB を VRAM に割り当てた状態で出荷される小型デスクトップです。Windows に LM Studio を入れるだけで、RTX 4090 や RTX 5090 には載らない gpt-oss-120b が、毎秒50トークンで動きました。
VRAM の大きさは、長い資料を読ませる場面でも効いています。マニュアル1冊と製品写真25枚、約10.4万トークンを一度に読ませると、17問中16問に正しく答え、仕様書とマニュアルの保証内容も照合できました。
VRAM に収まる小さなモデルなら、単体 GPU の PC のほうが速いです。マニュアル1冊程度の資料も、VRAM 24GB の RTX 3090 なら本機より速く読み終えました。価格も、同じチップの格安ミニPCよりは高い設定。
向いているのは、次のような方です。
- RTX 4090 や RTX 5090 には載らない、60GB を超える AI モデルを手元で動かしたい方
- マニュアルや仕様書の写真を何十枚もまとめて、外部のサービスに送らずに AI に読ませたい方
- 新しいオープンモデルが出るたびに、手元の PC で試したい方
- Linux や ROCm の環境を整えずに、Windows のままローカル LLM を使いたい方
- 国内メーカーの3年保証と、24時間365日の電話サポートを重視する方
反対に、次のような使い方が中心なら、ほかの選択肢のほうが合います。
- VRAM に収まるモデルや、マニュアル1冊程度の資料を速く処理したい:VRAM 24GB 以上の単体 GPU の PC
- 生成速度を重視し、macOS でもかまわない:メモリ128GB の Mac Studio
- トラブルを自分で調べて直せる:同じチップのミニPC
大きな AI モデルと長い資料を、Windows のまま、国内のサポート付きで手元で扱える小型デスクトップ。60GB を超えるモデルや、10万トークンを超える資料をローカルで使いたい方は、ぜひ候補に入れてみてください。