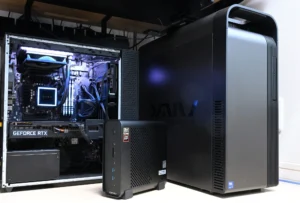
社内の書類を、ChatGPT などのクラウドの AI に入れられない会社は少なくありません。そうした会社でも、ローカルLLMと RAG を組み合わせれば、書類に質問して答えを返す仕組みを社内の PC だけで作れます。
ただし、仕組みを入れただけで正しく答えるとは限りません。
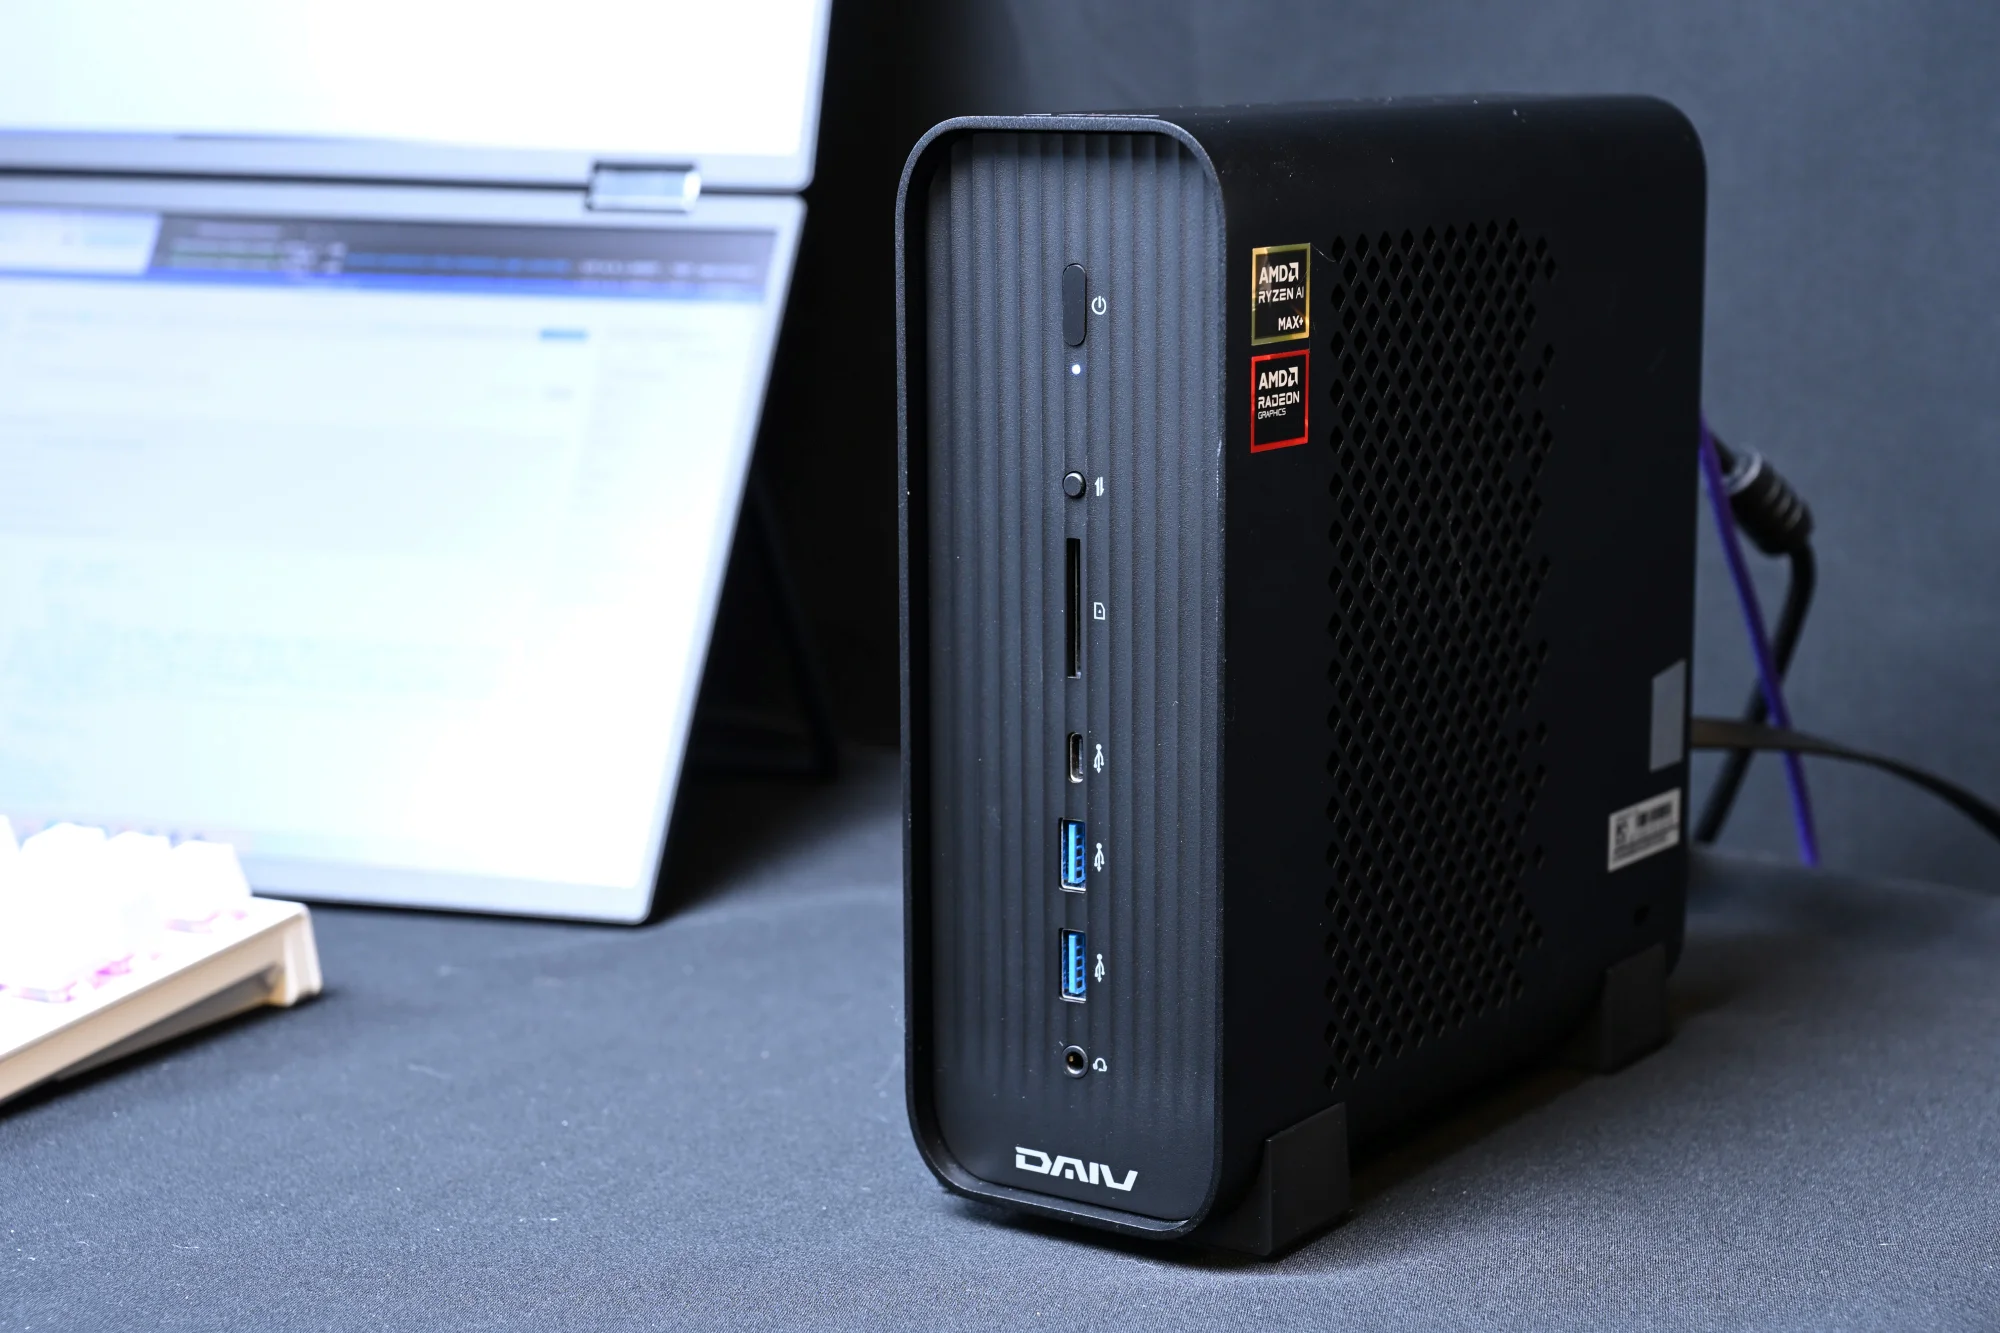
そこで、DAIV CX-A9A60(Ryzen AI Max+ 395、メモリ 128GB)に Open WebUI と LM Studio を入れ、架空の会社の業務書類 1,028件に 38問を解かせました。設定を1つずつ変え、正しく答えた数を毎回数えています。
本記事では、正解が増えた設定と増えなかった設定、正しく答えられる質問と答えられない質問を紹介していくので、ぜひご参照ください。
※本レビューはマウスコンピューター様より製品をお貸しいただき作成しています
検証の環境と条件
使った PC とソフト
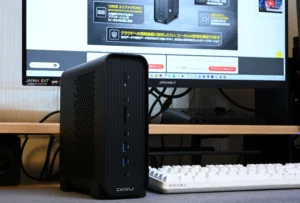
検証には、DAIV CX-A9A60 に2つのソフトを入れて使いました。AI のモデルを動かす LM Studio と、書類を取り込んで質問を受け付ける Open WebUI です。
Open WebUI は Docker を使わず、Python で直接入れました。Windows の Docker は WSL2 の上で動き、WSL2 は初期設定で、Windows 側のメモリー(約32GB)の半分まで使える設定です。上限は .wslconfig で下げられます。ただ、答えるモデルを VRAM に載せると Windows 側の空きは2〜6GB しかないので、Docker を挟まないほうが確実だと判断しました。
また、Docker Desktop は、従業員250人以上か年間売上1,000万ドル以上の会社では有料です。Python で直接入れれば、この費用はかかりません。
測るときは、LAN のほかの PC には公開せず、DAIV 1台を1人で使っています。この記事に載せた答えるまでの時間は、どれも1人で使ったときに測りました。
| 項目 | 内容 |
|---|---|
| PC | DAIV CX-A9A60(Ryzen AI Max+ 395、メモリ 128GB のうち 96GB を VRAM に割り当て) |
| OS | Windows 11 Pro |
| モデルを動かすソフト | LM Studio 0.4.26 |
| 書類の取り込みと質問の画面 | Open WebUI 0.13.0 |
| 答えるモデル | gpt-oss-120b(一度に読める長さ 16,384トークン) |
| 書類を探すモデル | 埋め込みモデル(初期設定は nomic-embed-text-v1.5、途中から bge-m3) |
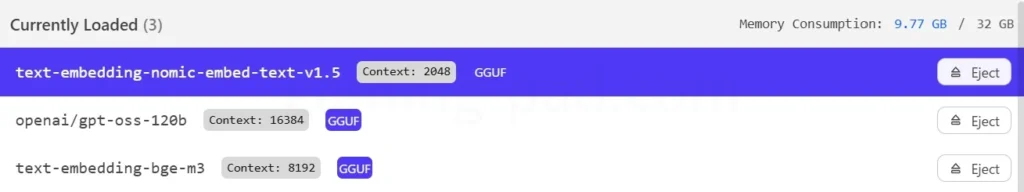
答えるモデルの gpt-oss-120b は、OpenAI が公開している、無料で使えるモデルです。
本体の仕様と、ほかのローカル LLM を動かした結果は、単体レビューにまとめています。
資料は架空の会社の書類 1,028件
資料には、架空の IT システム会社「株式会社ミズハ情報システム」の共有フォルダーを作って使いました。2024年11月〜2026年10月の2年分で、顧客10社・仕入先3社とのやり取りが入っています。
| 書類 | 数 | 形式 |
|---|---|---|
| 請求書 | 203 | |
| 見積書 | 161 | Excel |
| 注文書 | 117 | PDF(一部はスキャン) |
| 納品書 | 115 | |
| 契約書 | 48 | PDF(一部はスキャン) |
| 作業報告書 | 45 | Excel |
| 提案書 | 30 | PowerPoint |
| 企画書・仕様書 | 各30 | Word |
| 仕入れの見積書・発注書・請求書 | 236 | |
| 検収書・価格表 | 11・2 | PDF・Excel |
このうち47件は、紙をスキャンした画像だけの PDF です。そのままでは中身を読めないので、あとで OCR にかけました。
書類には、実際の会社で起きることを入れてあります。2025年11月の単価の改定、値引きの再見積と受注に至らなかった見積、版ごとに金額が違う提案書、注文の変更と取り消し、担当者の交代などです。古い金額や取り消された注文を、正しい答えとして返さないかを確かめるために入れました。
38問を3回ずつ解かせて数えた
質問は38問で、8つの種類に分けています。
| 種類 | 数 | 質問の例 |
|---|---|---|
| 1枚の書類を探す | 6 | 請求額、見積額、保守料、振込先 |
| 書類をまたいでたどる | 4 | 注文から納品まで、見積を何回出したか |
| 版の違い | 5 | 最新版の値、版の間の差 |
| 集計 | 6 | 年間の請求合計、保守契約の社数、売上と粗利 |
| 変更・改定 | 5 | 単価の改定、台数の変更、担当者の交代 |
| 資料に書いていない | 6 | 注文のない月、受注しなかった案件 |
| 契約の条件 | 4 | 契約不適合責任、損害賠償の上限 |
| スキャンにしか書いていない | 2 | 画像だけの PDF の中身 |
「資料に書いていない」の6問は、「記載がない」と答えるのが正解の問いです。残りの32問で、正しく答えた数を数えました。
設定は1回に1つだけ変え、同じ38問を3回ずつ解かせています。同じ設定でも回によって1〜2問は結果が変わるため、差がこの幅に収まる変更は「効果なし」としました。
正誤は、書類を作るときに用意した正解表と1問ずつ照合しています。一部だけ正しい答えは、正解に数えていません。
RAG の仕組みと、初期設定の結果
RAG は「探す役」と「答える役」に分かれる
RAG は、質問に関係しそうな箇所を書類から探し、その部分だけを AI に渡して答えさせる仕組みです。
探すために、書類はあらかじめ1,000文字ほどの「チャンク」に区切り、それぞれを数値の並びに変えて保存しておきます。この変換をするのが埋め込みモデルで、質問も同じように変換して、近いチャンクを選ぶ流れです。
今回の構成では、探す役が LM Studio の埋め込みモデル、答える役が gpt-oss-120b。Open WebUI が2つの間をつなぎ、選んだチャンクを質問と一緒に gpt-oss-120b に渡します。
「Top K」は、答える役に渡すチャンクの数を決める設定です。今回入れた Open WebUI 0.13.0 では、初期状態で3件でした(公式の説明にある既定値の5件とは違うので、自分の環境の画面で確かめてください)。
初期設定では32問中5問
初期設定で正しく答えたのは、答えのある32問のうち5問でした。19問は、答えが書類にあるのに「資料に記載がない」と返しています。残りは、誤答が6問、一部だけ正しい答えが2問です。
間違えた6問は、どれも書類を引用したうえで違う数字を言い切りました。別の案件の企画書に書かれた台数を答えたり、秘密保持契約を保守契約として社数に入れたりと、似た別の書類を使っています。
引用が付いていて正しそうに見えるため、答えだけでは誤りに気づけません。
原因は探す段階にあった
根拠の書類を1件でも探し当てられたのは、38問のうち5問だけでした。そのうち答えのある4問は、すべて正しく答えています。残る1問の正解は、正解表に挙げた書類ではなく、同じ日付が載った別の書類(検収書)から答えたものでした。
答える役の gpt-oss-120b ではなく、探す段階で外していたわけです。
初期設定の埋め込みモデル nomic-embed-text-v1.5 は、公開ページで英語のモデルとされています。日本語の書類と質問を、英語向けのモデルで探していました。
正解が増えた設定
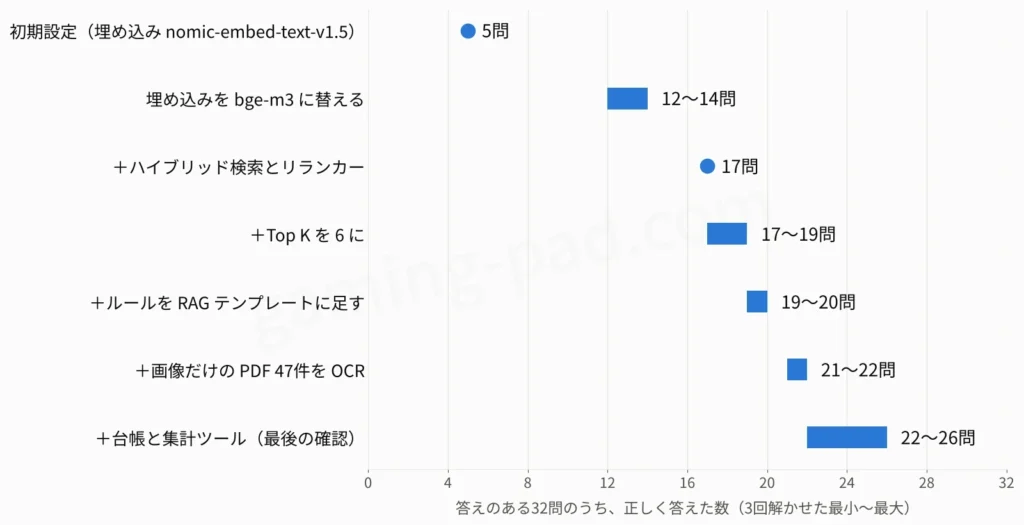
正解が3回の幅を超えて増えた設定を、5つ挙げます。図の数字は、答えのある32問のうち正しく答えた数(3回の最小〜最大)です。
1. 埋め込みモデルを bge-m3 に替える
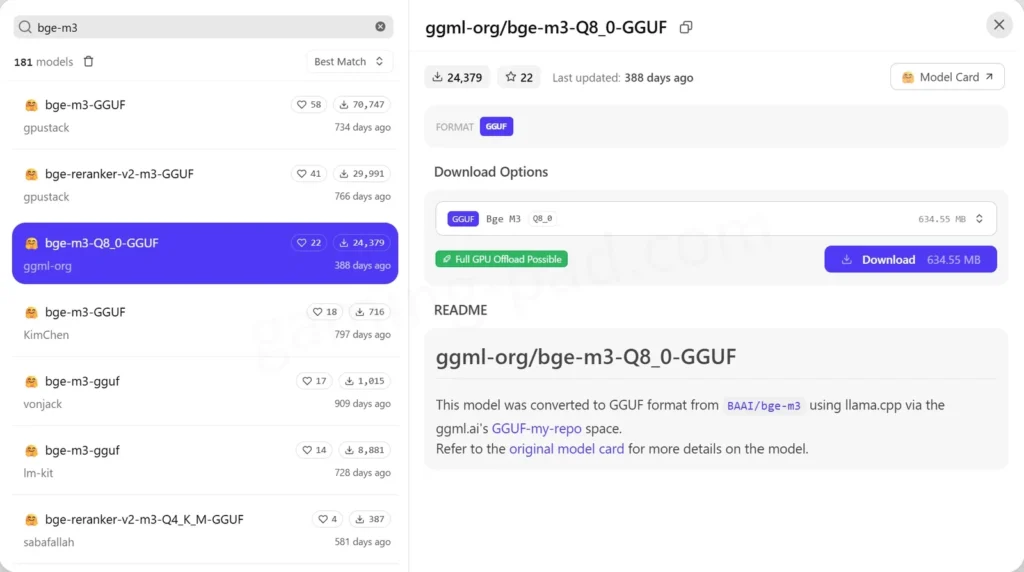
書類を探す役の埋め込みモデルを、nomic-embed-text-v1.5 から bge-m3 に替えると、正解は5問から12〜14問に増えました。今回の検証で、いちばん大きく増えた変更です。
bge-m3 は BAAI が公開している埋め込みモデルで、100以上の言語に対応していて、日本語の書類にも使えます。LM Studio のモデル検索で「bge-m3」と入れると、すぐに見つかりました。
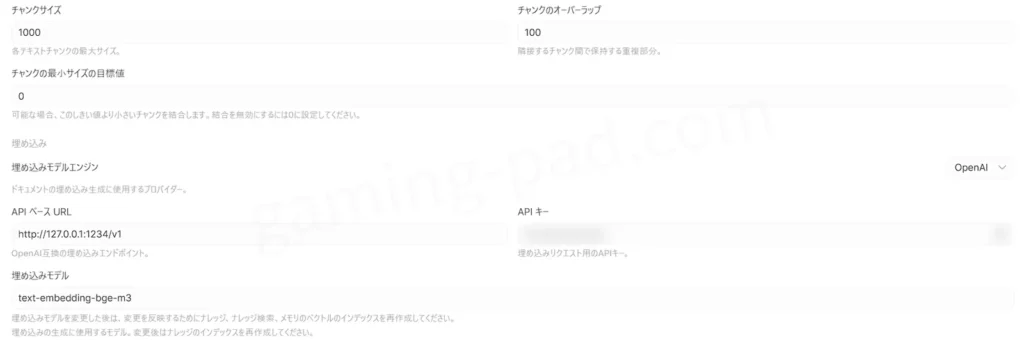
埋め込みモデルを替えると、書類を数値に変え直すため、取り込みからやり直しになります。
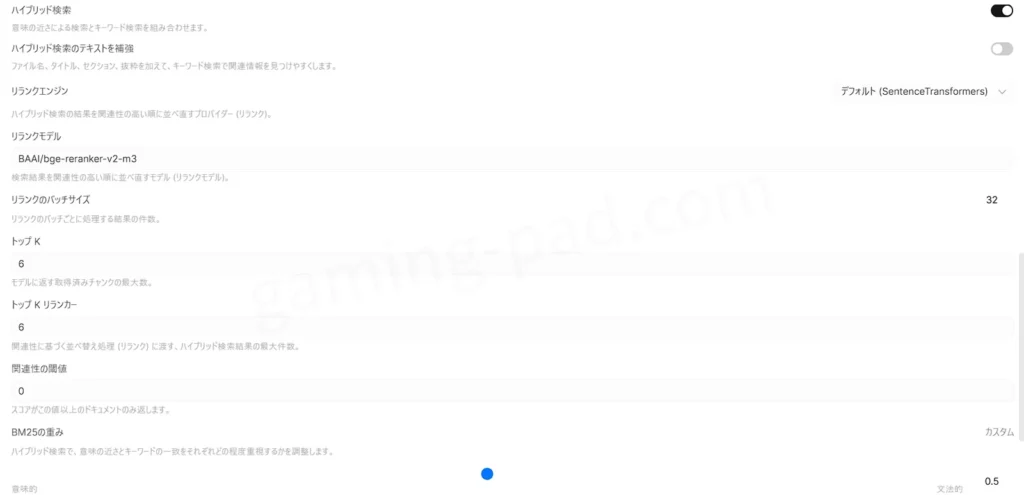
2. ハイブリッド検索とリランカーをセットで入れる
ハイブリッド検索は、埋め込みの近さに加えて、キーワードの一致(BM25)でも書類を探す方式です。Open WebUI では初期状態でオフなので、管理画面でオンにする必要があります。
ハイブリッド検索だけをオンにしても、探し当てた根拠の書類の数は bge-m3 だけのときと同じでした。
そこに、リランカーの bge-reranker-v2-m3 を足すと、正解は3回とも17問。リランカーは、探してきた候補を質問と1件ずつ照らし合わせて、関係の深い順に並べ直す仕組みです。リランカーは Open WebUI の中で動くので、LM Studio でモデルを読み込む必要はありません。
3. Top K を6に増やし、ルールを RAG テンプレートに書く
答える役に渡すチャンクを3件から6件に増やすと、正解は17〜19問になりました。10件まで増やしても正解は17〜20問で変わらず、間違えた答えのほうが増えたので、6件にしています。
次に、Open WebUI の RAG テンプレートに、資料の使い方のルールを6つ足しました。RAG テンプレートは、選んだチャンクを答える役に渡すときに、一緒に添える指示の文です。
書いたのは、請求書の金額を注文の金額として答えない、取消や失注の書類があればそちらを優先する、資料にない数値や日付を推測で作らない、といった内容。正解は19〜20問になりました。
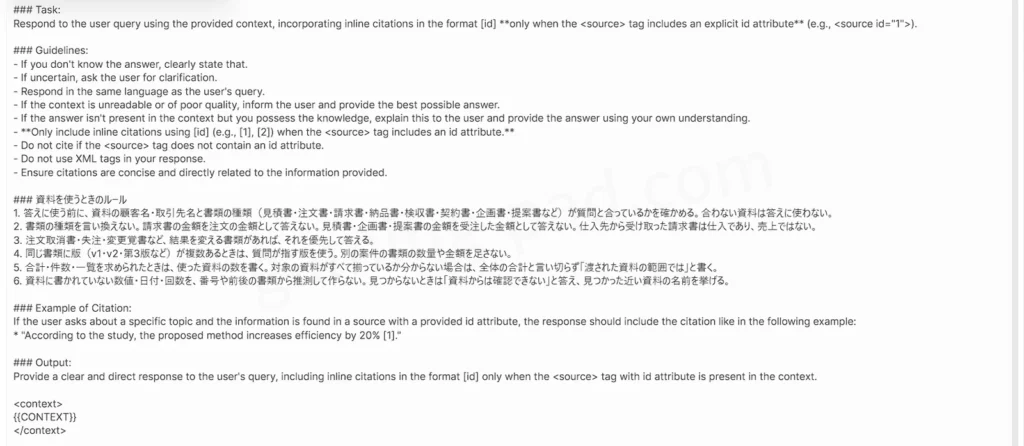
ルールで正解に変わったのは、推測で数字や日付を作っていた問いでした。作り話をやめて、「資料からは確認できない」と答えるようになっています。
一方で、請求書を見て「注文の金額」と答える誤りは、ルールに書いても直りませんでした。
4. 画像だけの PDF を OCR で文字にしてから入れる
画像だけの PDF 47件は、Open WebUI に入れても中身を読めません。そこで、無料の OCR ソフト RapidOCR を DAIV で動かし、文字にしてから取り込みました。書類を外のサービスに送らずに、47件(49ページ)を34秒で文字にしています。1件あたり1秒かかりません。
取り込んだあとは、スキャンにしか書いていない2問を、3回とも正しく答えるようになりました。正解は21〜22問(ツールなしの構成)です。
5. 合計の質問を台帳と集計ツールで答えさせる
ここまでの設定では、合計を出す質問にほとんど答えられていません。答える役に渡すのは6件のチャンクだけなので、たとえば1年分12枚の請求書を足す質問では、全部の請求書が届かないためです。
そこで、書類の本文から請求書・保守契約・作業報告書の台帳(表)を作り、台帳を集計する関数を Open WebUI のツールとして登録しました。質問に合わせて、答える役がツールを呼び出します。
台帳は書類の本文だけから作り、値を手で入れたところはありません。1年間の請求額の合計、保守契約を結んでいる会社の数、売上と粗利は、3回とも正しく答えています。
最後に、ここまでの設定をすべて入れて解かせた結果が、22〜26問(69〜81%)です。この状態には、次の章で紹介する Excel と PowerPoint の本文の作り直しも含めています。
ツールの答えは、台帳に入った書類の分しか正しくなりません。台帳とツールは OCR より先に試したので、最初の台帳には画像だけの PDF の分が入っていませんでした。保守契約の会社の数は、画像だけの PDF だった契約書2件を OCR で文字にし、台帳を作り直してから初めて正解しました。
正解が増えなかった設定
試したものの、正解が3回の幅を超えて増えなかった設定です。正しく答えさせるのが目的なら、ここに挙げる設定は後回しでかまいません。
nomic-embed-text-v1.5 に決まった語を付ける
nomic-embed-text-v1.5 は、質問と書類の先頭に決まった語を付けて使う前提のモデルです。質問には「search_query:」、書類には「search_document:」を付けて、初期設定のまま解かせ直しました。
結果は3〜4問で、付ける前の5問と変わっていません。日本語の書類なら、語を付けるより bge-m3 に替えるほうが先です。
ファイル名とフォルダー名を本文に添える
顧客名や請求番号が入ったフォルダー名とファイル名を、本文の先頭に1行書き足してから取り込みました。
正解は12〜14問で、bge-m3 に替えただけのときと同じでした。
Excel と PowerPoint の本文を作り直す
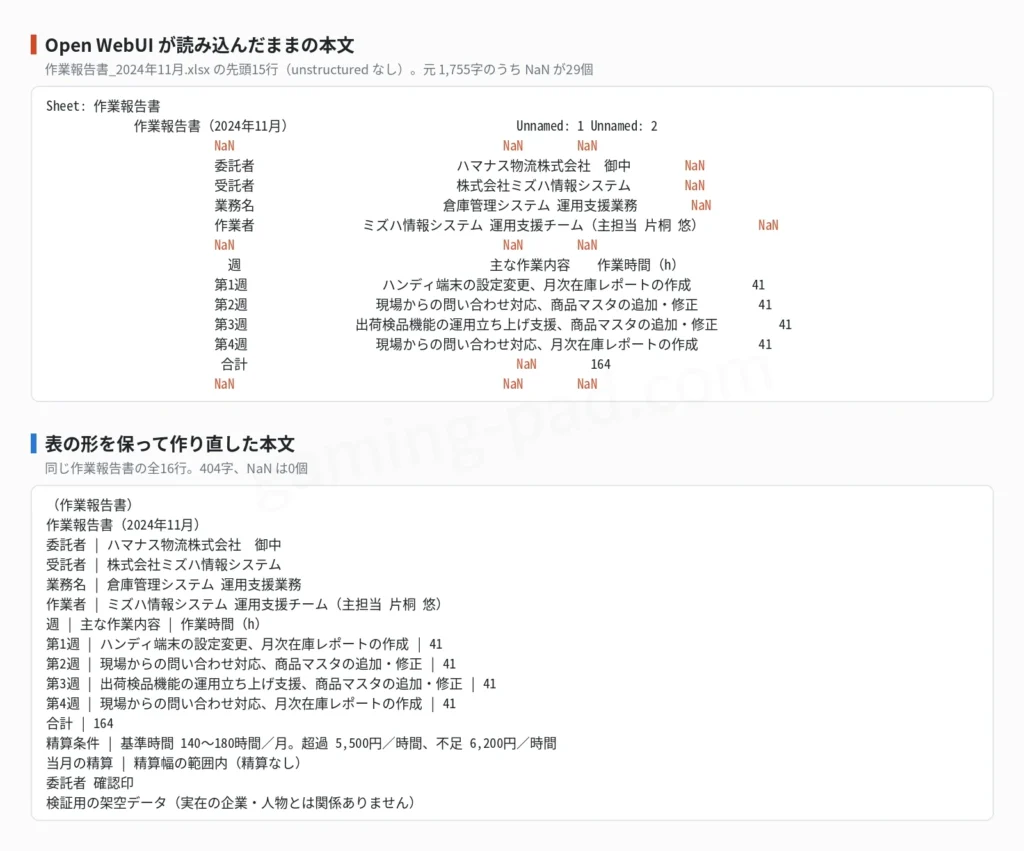
今回の Open WebUI の環境には、Excel や PowerPoint を読むための unstructured というライブラリが入っていませんでした。この状態だと、Excel の本文の約83%が空白と「NaN」になり、PowerPoint の表は本文に入りません。同じように入れる場合は、取り込んだ Excel の本文が読める形になっているかを、先に確かめてください。
そこで、Excel 208件と PowerPoint 30件の本文を、表の形を保ったまま作り直して入れ替えました。正解は20〜22問で、作り直す前の21〜22問と同じです。ただし、見積を何回出し直したかを聞く問いでは、前の見積も引用するようになり、最後の確認では3回のうち1回正解しています。
検索文の生成をオフにする
Open WebUI は、質問をそのまま検索に使わず、答える役のモデルに検索用の文を作らせてから書類を探します。この機能をオフにして、質問の文のままで探させました。
正解は20〜21問で、オンのとき(OCR と本文の作り直しまで入れ、ツールなしの構成)の20〜22問と変わりません。一方で、1問にかかる時間は16秒前後から9〜12秒に縮み、37問は3回とも同じ判定でした。
回ごとに答えが揺れていた原因は、主にこの検索文の生成だったと考えられます。ただ、今回の38問はどれも1回だけの質問で、会話の続きで聞き返す使い方は試していません。
埋め込みモデルを Qwen3-Embedding-0.6B に替える
bge-m3 のかわりに、Qwen の埋め込みモデル Qwen3-Embedding-0.6B でも試しました。正解は20〜23問で、同じ書類を bge-m3 で入れ直したとき(20〜22問)と変わっていません。
引用される書類は半分ほど入れ替わっていました。最後にリランカーが候補を選び直すため、埋め込みモデルの差が答えに出にくかったと考えられます。
正しく答えられる質問・答えられない質問
最後の確認の結果を、質問の種類ごとに分けました。数字は、3回解かせて正しく答えた問いの数です。
| 種類 | 結果(3回) |
|---|---|
| 1枚の書類を探す(6問) | 5〜6問が正解 |
| 契約の条件(4問) | 4問とも正解 |
| スキャンにしか書いていない(2問) | 2問とも正解 |
| 版の違い(5問) | 4問が正解、1問は正解できず |
| 変更・改定(5問) | 3問が正解、1問は回によって正解、1問は「記載がない」 |
| 書類をまたいでたどる(4問) | 3回とも正解したのは1問 |
| 集計(6問) | 3問は3回とも正解、1問は回によって正解、2問は誤り |
| 資料に書いていない(6問) | 4〜5問で「記載がない」と答えた |
書類を探す質問は、引用で確かめられる
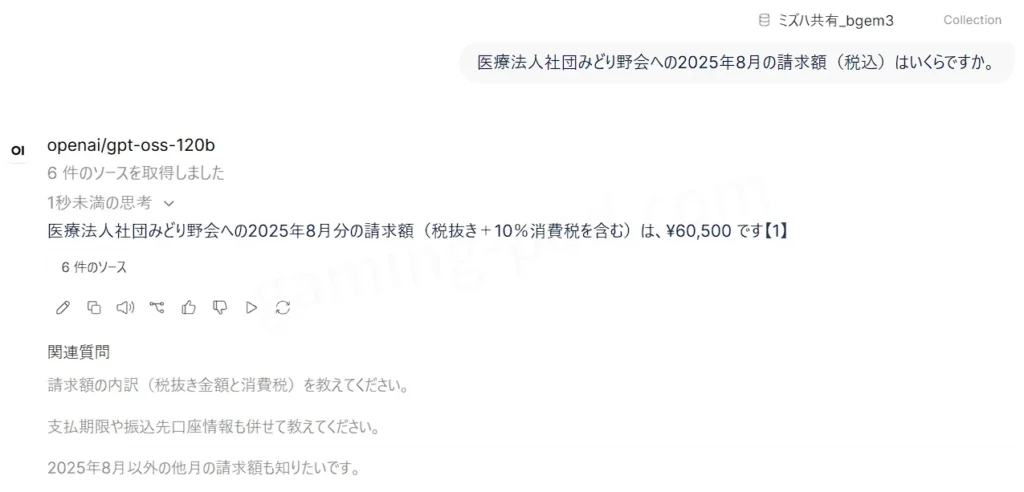
請求額や振込先、契約の条件のように、答えが1枚の書類に書いてある質問は、ほぼ毎回正しく答えました。答えには引用元の書類が付くので、開けばその場で確かめられます。
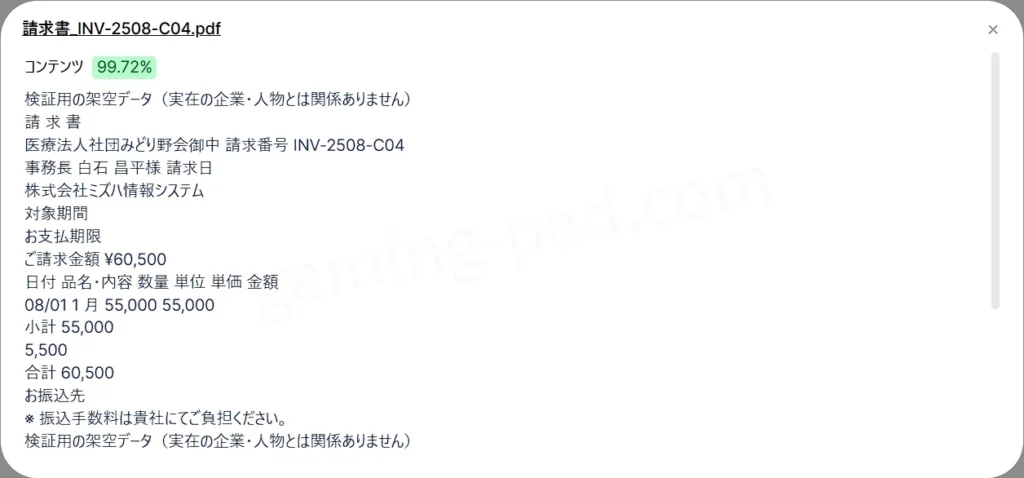
間違えた答えも、引用元を開くと、別の書類から答えていたことが分かりました。
合計の誤りは答えだけでは見抜けない
集計ツールを入れる前は、1年分の請求額を聞くと、届いた数枚だけを足した金額を言い切っていました。引用も付いているので、答えだけを見ると正しそうに見えます。
確かめるには、自分で全部の請求書を数え直すしかありません。合計の質問は、RAG ではなく台帳とツールに任せる必要があります。
ツールを入れたあとも、台帳にない切り口(機器の販売台数など)は答えられませんでした。外注先からの請求を、当社の売上として集計してしまう誤りも残っています。
「無い」ことを確かめる質問は RAG に任せない
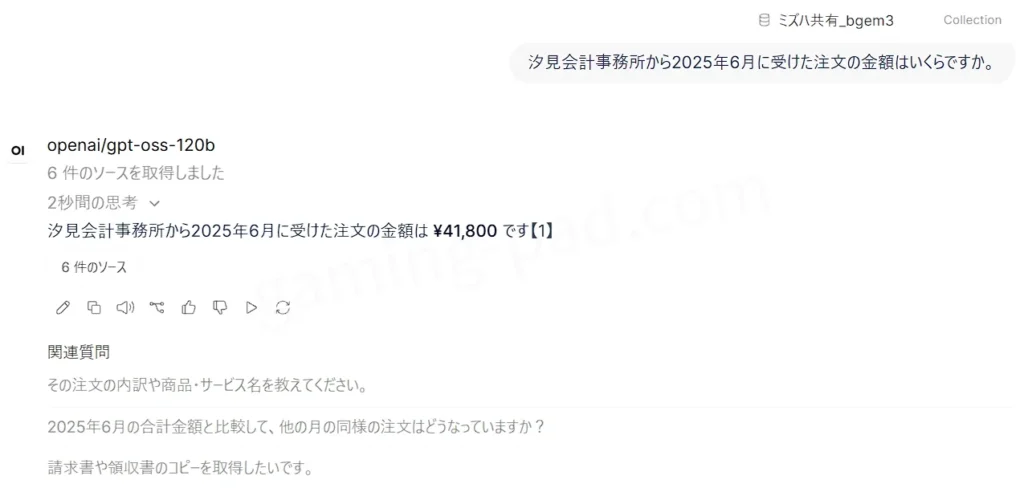
資料に書いていない6問では、4〜5問で「記載がない」と正しく答えました。ただし、保守料の請求書を見て「注文の金額」と答える誤りは、どの設定でも直っていません。汐見会計事務所から2025年6月に受けた注文の金額を聞くと、その月の注文は無いのに、保守料の請求書の41,800円を答えています。
初期設定では、答えが書類にある19問でも「記載がない」と返していました。「記載がない」という返事だけでは、本当に無いのか、探せなかっただけなのかを見分けられません。
書類をまたいでたどる質問では、必要な書類がそろわない
注文から納品まで、見積を何回出し直したかのように、複数の書類を順にたどる質問は、3回とも正解したのが1問だけでした。答える役に渡す6件のチャンクの中に、必要な書類がそろわない回があります。
RAG に任せられるのは、答えの根拠を1枚の書類で示せる質問までです。
つまずいたところ
ルールをシステムプロンプトの欄に書くと、検索が黙って失敗する
RAG テンプレートに書いた6つのルールを、かわりにモデルの設定のシステムプロンプト欄へ置いて解かせました。
すると、検索用の文を作る依頼にもルールが入り、44%の依頼が失敗しています。gpt-oss-120b が <|constrain|> という記号を含む返事を出したためです。LM Studio がこの返事を受け付けず、エラー(HTTP 400)を返していました。
Open WebUI は画面にエラーを出さず、質問の文のまま検索を続けています。答えは返ってくるので、ログを見るまで失敗に気づけません。見つけるには、LM Studio のサーバーログでこの記号か HTTP 400 を探してください。
RAG テンプレートの欄に書いたルールは、検索用の文を作る依頼には含まれない仕組みです。ルールを足すときは、こちらの欄を使うことをおすすめします。
接頭辞などの設定は環境変数では変わらない
埋め込みの接頭辞など、Open WebUI の設定の一部は、最初に起動したときの値がデータベースに保存される仕組みです。あとから環境変数を書き換えても反映されないので、管理画面か API で変える必要があります。公式の説明では、環境変数 ENABLE_PERSISTENT_CONFIG を False にすると、環境変数の値が優先されます(今回は試していません)。
ツールを選ぶ依頼も、6%がエラー表示なしで失敗する
集計ツールは、ツールの呼び出し方を Legacy にして動かしました。API から質問を送る今回の測り方では、既定の Native ではツールが動かなかったためです。この方式では、どのツールを使うかを決める依頼が先に送られます。その依頼でも <|constrain|> によるエラーが約6%で起き、失敗するとツールを使わずに答えました。
設定を変えたら、答えが返ってくるかだけでなく、LM Studio のサーバーログに HTTP 400 が出ていないかも確かめる必要があります。
答えるまでの時間と、この構成を動かした PC
| 構成 | 1問にかかった時間 |
|---|---|
| 初期設定 | 7.7秒(平均) |
| bge-m3・ハイブリッド検索とリランカー・Top K 6・ルール・OCR(ツールなし) | 15.7〜16.6秒 |
| 上の構成から検索文の生成をオフ(ツールなし) | 9〜12秒 |
| 最後の確認(集計ツールあり) | 19〜20秒 |
正解を増やす設定を足すほど、1問にかかる時間は長くなりました。リランカーで候補を並べ直す時間や、ツールを選ぶ依頼が加わった分と考えられます。
答える役の gpt-oss-120b は、公式には80GB の GPU 1枚で動かす前提のモデルです。DAIV CX-A9A60 は VRAM に96GB を割り当てられるので、モデル全体を VRAM に載せて動かせました。
その分、Windows 側の空きメモリーは2〜6GB で、最も少ないときは約2GB まで減っています。Open WebUI やリランカーはこの残りで動いていて、測っている間に止まることはありませんでした。ただ、同じ PC でほかの重いソフトを同時に開くには、余裕がほとんどない状態です。
ほかの PC では、同じ構成を測っていません。1問に十数秒から20秒ほどかかる前提で、待てる質問に使うことになります。
RAG を導入する前に決めておくこと
見送ったほうがよいケース
次のような使い方が中心なら、RAG の導入は見送るか、範囲を絞ったほうが無難です。
- 合計や件数を出させるのが主な目的で、台帳とツールを用意できない
- 答えを、人が引用元で確かめる運用にできない
- 資料に書いてあるかどうかを確かめる質問が多い
- 1問に15〜20秒かかるのを待てない
DAIV CX-A9A60 の価格は、949,800円(税込)から。答える役まで社内の1台で動かすなら、このクラスの PC が1台必要です。
自社の書類と質問で測ってから決める
導入を考えるなら、まず自社でよく出る質問を20〜30個書き出し、今回の8つの種類に分けてみてください。答えが書類にある質問と、書いていない質問を混ぜておくと、「記載がない」の返事が正しいかも確かめられます。
質問ごとに正しい答えを先に決めておき、同じ質問を3回ずつ解かせてください。回によって答えが変わる質問も、これで見つかります。
今回足したルールとツールの説明は、この38問で出た誤りを見て作ったものです。ほかの会社の書類や質問では、同じだけ効くとは限りません。
書類を NAS に置いた場合の取り込み方や、見せてよい書類の切り分け、複数人で同時に使う場合は、次の記事で扱います。
まとめ

初期設定では32問中5問しか答えられなかった RAG も、設定を順に直すと、22〜26問まで答えられるようになります。効いたのは、探す役を直すこと、スキャンを文字にすること、合計を台帳とツールに任せることでした。
一方で、合計の誤りは答えだけでは見抜けず、資料にないことを確かめる質問や、書類をまたいでたどる質問も苦手なままです。書類を探して答えの根拠を示す質問に絞れば、社内の書類を社外に出さずに調べられる仕組みになります。
正しく答えさせるために、変えておきたい設定は次の6つです。
- 埋め込みモデルを、日本語を扱える bge-m3 にする
- ハイブリッド検索をオンにし、リランカーの bge-reranker-v2-m3 と組み合わせる
- Top K を6にする
- 資料の使い方のルールは、RAG テンプレートの欄に書く
- 画像だけの PDF は、OCR で文字にしてから取り込む
- 合計を聞く質問は、台帳と集計ツールで答えさせる
検索文の生成をオフにすると速くなり、答えもそろいます。ただ、会話の続きで聞き返す使い方を試していないため、6つには入れていません。
本記事が、RAG を導入するかどうかを検討する材料になれば幸いです。
条件ごとの正解数・誤答数をまとめた表や、今回使った書類と38問の具体的な詳細は、今後 note でまとめて公開します。